



Newsletter Subscribe
Enter your email address below and subscribe to our newsletter
[forminator_form id="25163"]

All voices matter
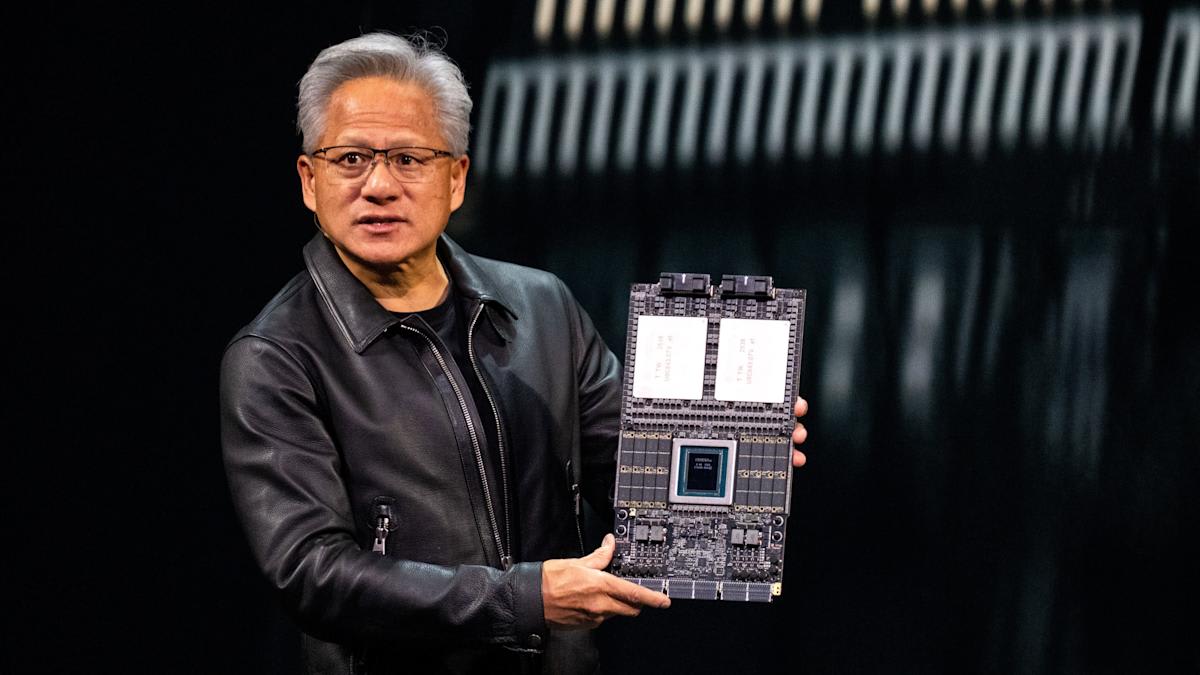
servethehome+1theplanettools+1thenextweb+1Nvidia profite du SIGGRAPH 2026 à Los Angeles pour approfondir les fondements techniques de son CPU Vera, le premier processeur pour centres de données entièrement personnalisé de l'entreprise et son défi le plus direct à ce jour contre AMD Advanced Micro Devices, Inc. et Intel sur le marché des serveurs.
La conférence, qui se déroule jusqu'au 23 juillet, propose des sessions sur le rôle de Vera dans l'infrastructure des usines d'IA, parallèlement aux annonces plus larges de Nvidia en matière de graphismes et de simulation. Les présentations s'appuient sur des mois de révélations progressives depuis que la puce a été présentée pour la première fois au CES en janvier et lancée officiellement lors du GTC Taipei le 31 mai.nvidianews.nvidia+3
Au cœur de Vera se trouvent 88 cœurs Olympus personnalisés, la première conception de cœur CPU interne de Nvidia depuis l'ère Denver il y a près de dix ans. Construit sur le jeu d'instructions Arm v9.2-A, Olympus dispose d'un décodeur d'instructions à 10 voies, plus large que le Zen 5 d'AMD à huit voies et le Granite Rapids d'Intel à six voies, associé à des prédicteurs de branchement neuronaux doubles. Nvidia vise 1,5 fois les instructions par cycle de son CPU prédécesseur Grace, qui utilisait des cœurs Arm Neoverse V2 sous licence.servethehome
La puce utilise ce que Nvidia appelle le multithreading spatial, partitionnant physiquement les ressources de chaque cœur pour fournir 176 threads plutôt que de s'appuyer sur le multithreading simultané traditionnel. La conception maintient les 88 cœurs sur une seule puce de calcul, éliminant les domaines NUMA et garantissant un accès uniforme à la bande passante mémoire LPDDR5X de 1,2 To/s, soit environ le triple de la bande passante par cœur des conceptions x86 concurrentes, selon Nvidia.digitalapplied+1
Des tests indépendants réalisés par Phoronix fin mai ont placé Vera environ 55 % devant le Xeon 6980P d'Intel et environ 10 % plus rapide que l'EPYC 9575F d'AMD dans une moyenne géométrique de benchmarks, tout en enregistrant une compilation du noyau Linux en 20 secondes, la plus rapide jamais mesurée par le site. Dans les charges de travail d'IA agentique en sandbox, Nvidia a revendiqué une exécution des tâches jusqu'à 1,8 fois plus rapide que les processeurs x86 les plus performants.theplanettools+3
Tom's Hardware a rapporté cette semaine que Nvidia met l'accent sur les performances monothread de Vera comme son principal avantage pour les charges de travail agentiques, où les agents doivent exécuter des appels d'outils séquentiels, exécuter du code et traiter les résultats entre les invocations de modèles. La conception monolithique de la puce évite les pénalités de latence entre les chiplets que peuvent subir les processeurs x86 multi-puces.tomshardware+2
Nvidia a commencé à livrer personnellement les premiers systèmes Vera en mai à Anthropic, OpenAI, SpaceX et Oracle Cloud Infrastructure. Oracle devrait être le premier hyperscaler à déployer la puce à grande échelle, avec une disponibilité cloud plus large attendue plus tard cette année.linkedin+2
Notamment, Nvidia prévoit de vendre Vera en tant que CPU autonome, et non seulement groupé avec les GPU Rubin dans ses racks NVL72, marquant la première tentative sérieuse de l'entreprise de concurrencer le marché général des CPU de serveurs. AMD a déjà réagi, affirmant que son futur processeur Zen 6 "Venice" à 256 cœurs offrira 3,3 fois les performances au niveau du rack de Vera à puissance équivalente.tomshardware+1


