



Newsletter Subscribe
Enter your email address below and subscribe to our newsletter
[forminator_form id="25163"]

All voices matter
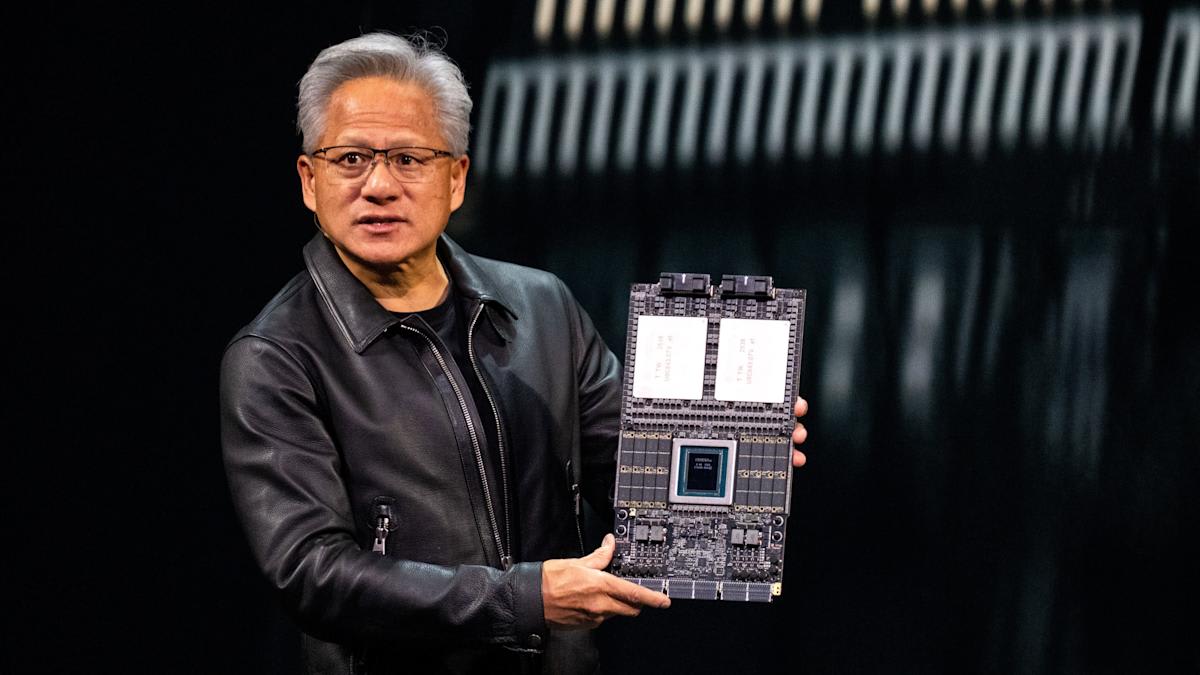
servethehome+1theplanettools+1thenextweb+1Nvidia nutzt die SIGGRAPH 2026 in Los Angeles, um die technischen Grundlagen seiner Vera-CPU zu erläutern, dem ersten vollständig maßgeschneiderten Rechenzentrumsprozessor des Unternehmens und seiner bisher direktesten Herausforderung für AMD Advanced Micro Devices, Inc. und Intel auf dem Servermarkt.
Die Konferenz, die bis zum 23. Juli läuft, umfasst Sitzungen über die Rolle von Vera in der Infrastruktur von KI-Fabriken sowie Nvidias breitere Ankündigungen zu Grafik und Simulation. Die Präsentationen bauen auf monatelangen, schrittweisen Enthüllungen auf, seit der Chip erstmals auf der CES im Januar gezeigt und am 31. Mai auf der GTC Taipei offiziell vorgestellt wurde.nvidianews.nvidia+3
Das Herzstück von Vera bilden 88 maßgeschneiderte Olympus-Kerne, Nvidias erstes hauseigenes CPU-Kerndesign seit der Denver-Ära vor fast einem Jahrzehnt. Basierend auf dem Arm v9.2-A Befehlssatz verfügt Olympus über einen 10-fach breiten Befehlsdekoder, der breiter ist als der von AMDs Zen 5 (achtfach) und Intels Granite Rapids (sechsfach), gepaart mit dualen neuronalen Sprungvorhersagen. Nvidia strebt die 1,5-fache Anzahl an Instruktionen pro Taktzyklus (IPC) gegenüber seinem Vorgänger, der Grace-CPU, an, die lizenzierte Arm Neoverse V2-Kerne verwendete.servethehome
Der Chip nutzt das, was Nvidia als räumliches Multithreading bezeichnet, bei dem die Ressourcen jedes Kerns physisch partitioniert werden, um 176 Threads bereitzustellen, anstatt sich auf herkömmliches simultanes Multithreading zu verlassen. Das Design hält alle 88 Kerne auf einem einzigen Rechen-Chiplet, eliminiert NUMA-Domänen und gewährleistet einen gleichmäßigen Zugriff auf die 1,2 TB/s LPDDR5X-Speicherbandbreite, was laut Nvidia etwa der dreifachen Bandbreite pro Kern im Vergleich zu konkurrierenden x86-Designs entspricht.digitalapplied+1
Unabhängige Tests von Phoronix Ende Mai platzierten Vera etwa 55 Prozent vor Intels Xeon 6980P und rund 10 Prozent schneller als AMDs EPYC 9575F im geometrischen Mittel der Benchmarks, während eine Linux-Kernel-Kompilierung in 20 Sekunden aufgezeichnet wurde, die schnellste Zeit, die das Portal jemals gemessen hat. Bei agentenbasierten KI-Sandbox-Workloads hat Nvidia eine bis zu 1,8-mal schnellere Aufgabenabwicklung als die leistungsstärksten x86-Prozessoren beansprucht.theplanettools+3
Tom's Hardware berichtete diese Woche, dass Nvidia die Single-Thread-Leistung von Vera als seinen Hauptvorteil für agentenbasierte Workloads hervorhebt, bei denen Agenten sequenzielle Tool-Aufrufe ausführen, Code ausführen und Ergebnisse zwischen Modellaufrufen verarbeiten müssen. Das monolithische Die-Design vermeidet die Latenzstrafen, die bei Multi-Die-x86-Prozessoren auftreten können.tomshardware+2
Nvidia begann im Mai mit der Auslieferung der ersten Vera-Systeme an Anthropic, OpenAI, SpaceX und Oracle Cloud Infrastructure. Oracle soll der erste Hyperscaler sein, der den Chip in großem Maßstab einsetzt, wobei eine breitere Cloud-Verfügbarkeit für später in diesem Jahr erwartet wird.linkedin+2
Bemerkenswert ist, dass Nvidia plant, Vera als eigenständige CPU zu verkaufen, nicht nur gebündelt mit Rubin-GPUs in seinen NVL72-Racks, was den ersten ernsthaften Versuch des Unternehmens markiert, auf dem allgemeinen Server-CPU-Markt zu konkurrieren. AMD hat bereits reagiert und behauptet, dass sein kommender 256-Kern-Prozessor Zen 6 Venice die 3,3-fache Leistung von Vera auf Rack-Ebene bei gleichem Stromverbrauch liefern wird.tomshardware+1


