Newsletter Subscribe
Enter your email address below and subscribe to our newsletter
[forminator_form id="25163"]

All voices matter
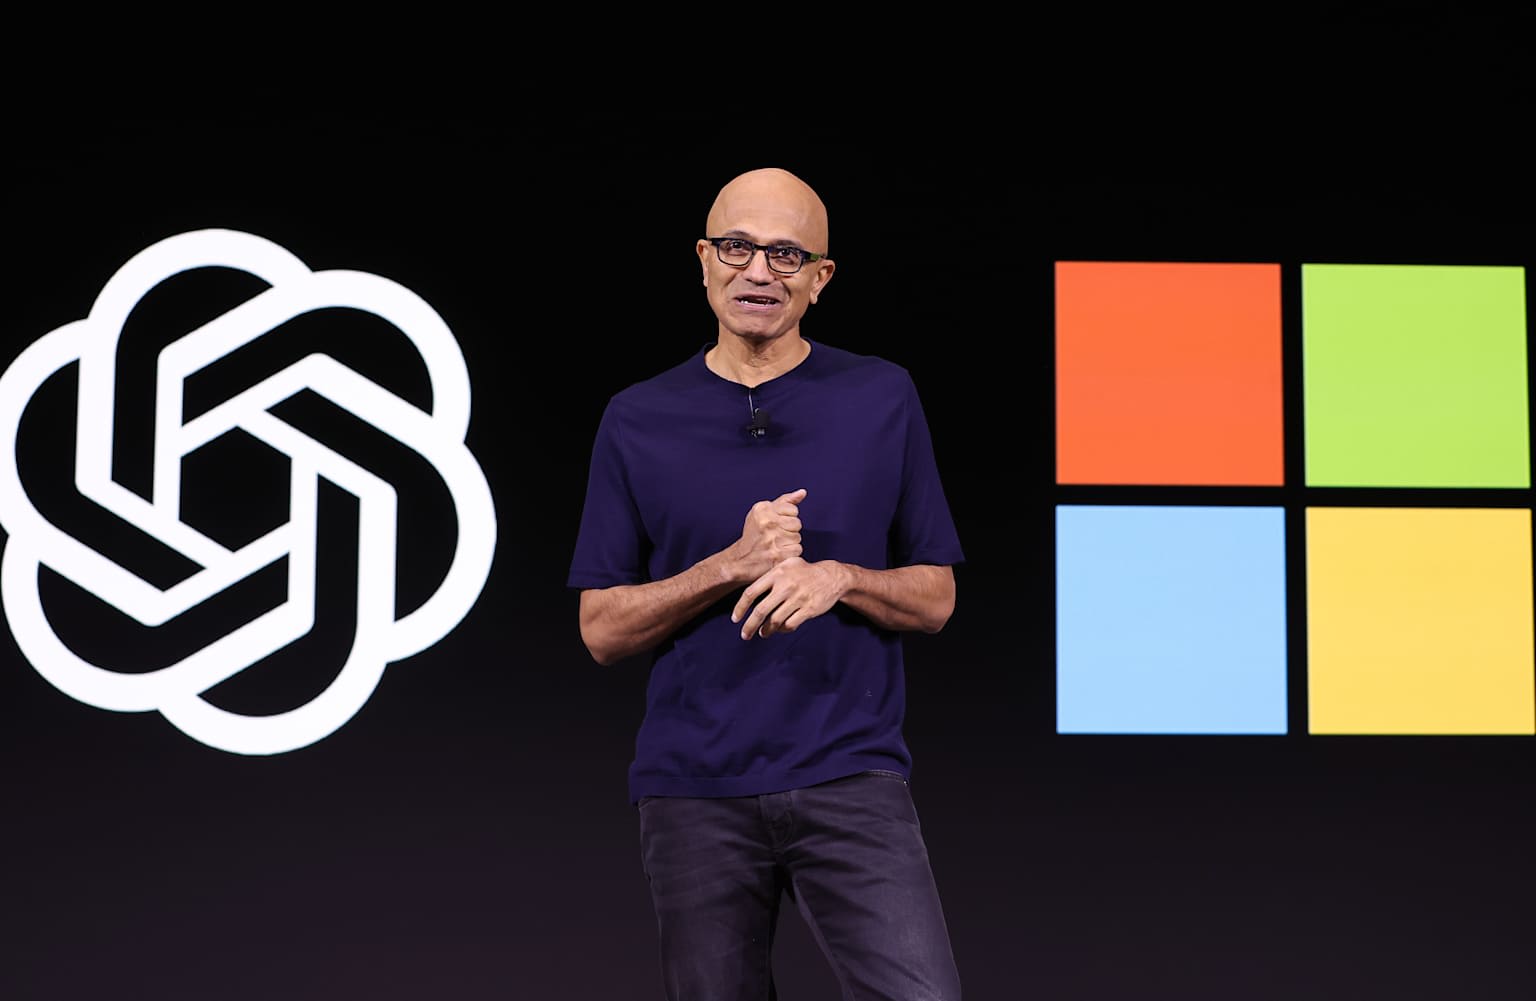
techcrunchtechcrunchtechcrunchDe nouveaux documents non caviardés dans le cadre du procès pour droits d'auteur intenté par le New York Times contre OpenAI et Microsoft révèlent que des cadres supérieurs des deux entreprises ont reconnu en privé que leurs pratiques d'entraînement de l'IA équivalaient à du vol et constituaient une menace existentielle pour les éditeurs dont le travail alimentait leurs modèles.
Les documents déclassifiés, rendus publics jeudi, montrent que le directeur de la science appliquée chez Microsoft, Brent Hecht, a décrit le scraping massif de contenu d'actualité comme "un vol stupéfiant de proportions sans précédent" et "le plus grand vol de travail de l'histoire de l'humanité" dans une note interne de janvier 2023. Dans une présentation distincte de janvier 2024, Hecht a averti que l'approche de Microsoft en matière d'IA avait créé une "boucle de la mort" qui "nuirait à la performance de nos modèles et à l'ensemble du web en même temps".wsj+1
Les propres données de Microsoft ont montré que son "moteur de réponses" Copilot a entraîné une baisse des taux de clics vers le domaine du Times allant jusqu'à 93% par rapport à la recherche Bing traditionnelle. Le responsable de ChatGPT chez OpenAI, Nick Turley, a écrit en interne que les éditeurs font face à une "menace existentielle" de la part de produits comme le chatbot, qu'il a décrit comme "largement substitutif". Le président d'OpenAI, Greg Brockman, a qualifié les modèles d'"excellents pour les actualités", tandis que le PDG de Microsoft, Satya Nadella, a témoigné sous serment que converser avec des chatbots "a substitué… le fait de vous donner l'information directement sur le site web de la plateforme d'IA plutôt que d'avoir besoin d'aller à la source originale".techcrunch
Les dossiers révèlent pour la première fois l'ampleur de la copie présumée: les jeux de données d'entraînement intermédiaire d'OpenAI contenaient à eux seuls plus de 91 692 copies d'œuvres publiées par le Times, le Daily News et le Center for Investigative Reporting, tandis qu'un jeu de données dérivé de Common Crawl incluait plus de 2 millions de documents provenant de nytimes.com. Les entreprises auraient également rassemblé des données d'entraînement via des initiatives appelées Project Taxi et Project Mango, cette dernière contenant des copies d'au moins 160 903 œuvres uniques provenant des éditeurs de presse.techcrunch
Les documents décrivent comment les employés d'OpenAI auraient conçu des méthodes pour contourner les paywalls sans être détectés. Lorsqu'un chercheur, Nick Ryder, a parlé à Brockman d'une "astuce pour contourner le paywall du nytimes", Brockman a répondu: "ah sympa". Les employés auraient également supprimé les avis de droits d'auteur des données d'entraînement, car les chercheurs "ne voudraient pas que le modèle affiche" de tels avis aux utilisateurs.techcrunch
Ces aveux pourraient fragiliser la défense d'usage loyal d'OpenAI, en particulier l'exigence selon laquelle l'utilisation ne doit pas nuire au marché de l'œuvre originale. Nadella lui-même a témoigné que "tout ce qui est derrière un paywall devrait être sous licence par quiconque souhaite l'utiliser… pour l'ancrage ou l'entraînement". Plus tôt ce mois-ci, l'administration Trump a déposé un mémoire en défense de l'utilisation sans licence de matériel protégé par le droit d'auteur par OpenAI, selon TechCrunch. OpenAI et Microsoft n'ont pas répondu aux demandes de commentaires.techcrunch