Newsletter Subscribe
Enter your email address below and subscribe to our newsletter
[forminator_form id="25163"]

All voices matter
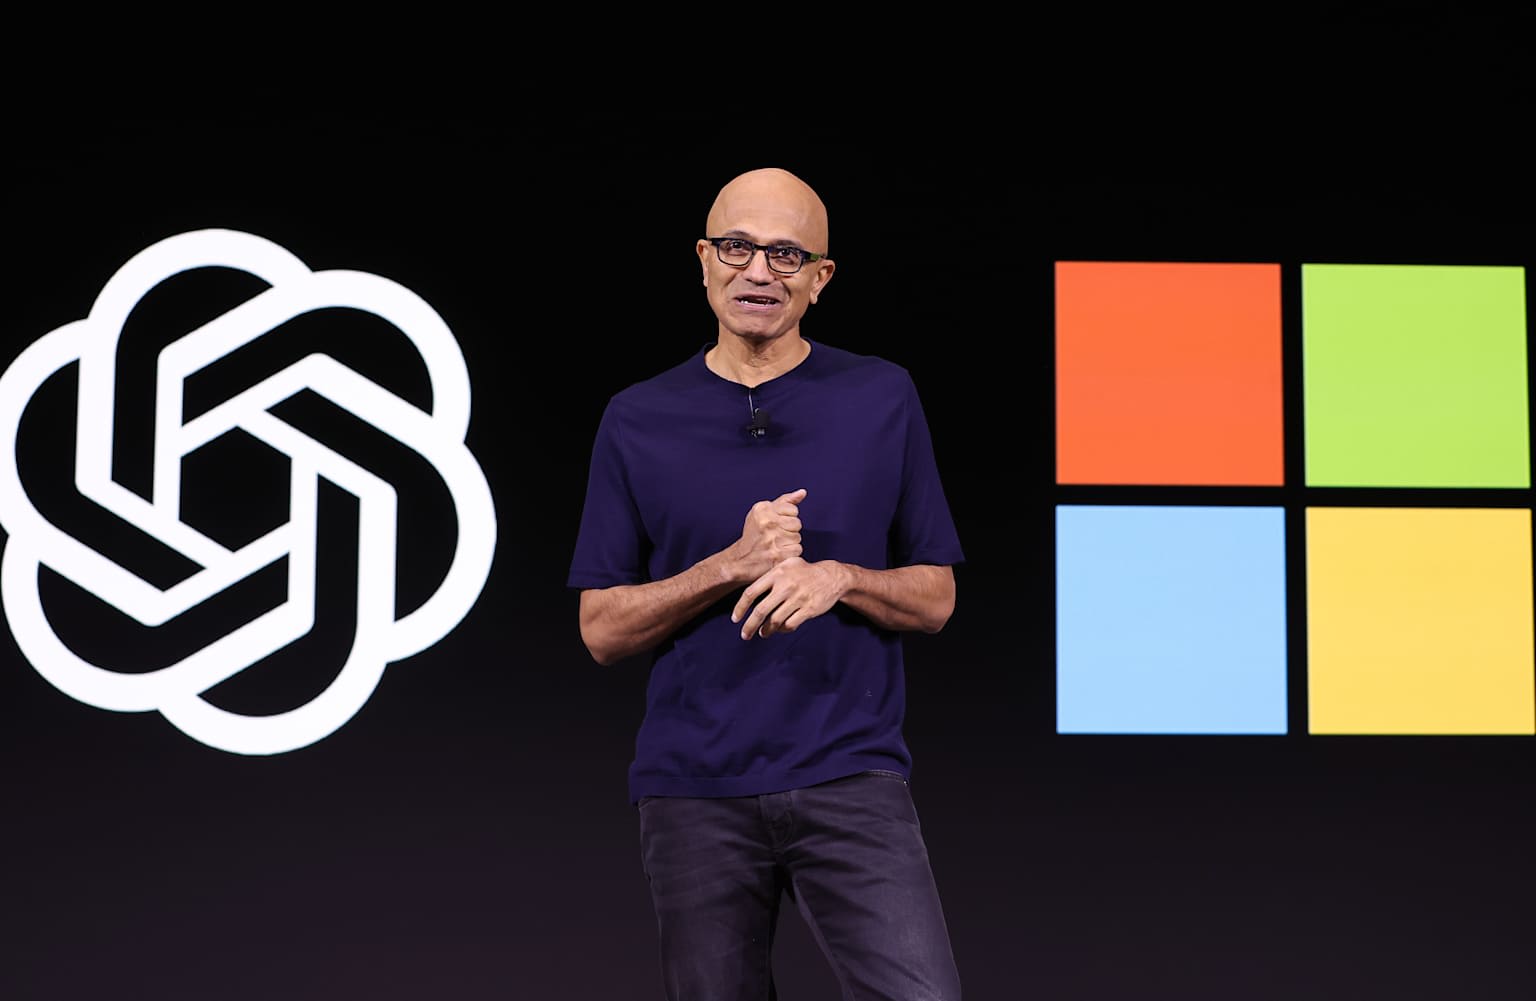
techcrunchtechcrunchtechcrunchNew York Times-ի կողմից OpenAI-ի և Microsoft-ի դեմ հարուցված հեղինակային իրավունքի երեքամյա դատական գործի շրջանակներում նոր բացահայտված փաստաթղթերը ցույց են տալիս, որ երկու ընկերությունների բարձրաստիճան ղեկավարները մասնավոր զրույցներում ընդունել են, որ իրենց AI-ի ուսուցման պրակտիկան հավասարազոր է գողության և գոյաբանական սպառնալիք է ներկայացնում այն հրատարակիչների համար, որոնց աշխատանքը սնուցում է իրենց մոդելները:
Հինգշաբթի օրը հրապարակված փաստաթղթերը ցույց են տալիս, որ Microsoft-ի կիրառական գիտությունների տնօրեն Բրենտ Հեխտը 2023 թվականի հունվարի ներքին հուշագրում ընկերությունների կողմից նորությունների զանգվածային հավաքագրումը նկարագրել է որպես "աննախադեպ մասշտաբի ապշեցուցիչ գողություն" և "մարդկության պատմության մեջ աշխատանքի ամենամեծ գողություն": 2024 թվականի հունվարի շնորհանդեսում Հեխտը զգուշացրել է, որ Microsoft-ի AI-ի վրա հիմնված մոտեցումը ստեղծել է "կործանման օղակ", որը "կվնասի ինչպես մեր մոդելների աշխատանքին, այնպես էլ ամբողջ համացանցին":wsj+1
Microsoft-ի սեփական տվյալները ցույց են տվել, որ իր Copilot "պատասխանների շարժիչը" Times-ի դոմենի սեղմումների ցուցանիշը նվազեցրել է մինչև 93%-ով՝ համեմատած ավանդական Bing որոնման հետ: OpenAI-ի ChatGPT-ի ղեկավար Նիկ Թերլին ներքին նամակագրության մեջ գրել է, որ հրատարակիչները կանգնած են "գոյաբանական սպառնալիքի" առաջ այնպիսի արտադրանքների պատճառով, ինչպիսին չաթբոտն է, որը նա նկարագրել է որպես "մեծապես փոխարինող": OpenAI-ի նախագահ Գրեգ Բրոքմանը մոդելներն անվանել է "նորությունների հարցում հիանալի", մինչդեռ Microsoft-ի գործադիր տնօրեն Սաթյա Նադելան երդման տակ ցուցմունք է տվել, որ չաթբոտների հետ զրուցելը "փոխարինում է… տեղեկատվությունը անմիջապես կայքում ստանալուն, փոխանակ օգտատերը գնա սկզբնաղբյուրի մոտ":techcrunch
Փաստաթղթերն առաջին անգամ բացահայտում են ենթադրյալ պատճենման մասշտաբը. միայն OpenAI-ի ուսուցման միջանկյալ տվյալների բազաները պարունակում էին Times-ի, Daily News-ի և Հետաքննական լրագրության կենտրոնի կողմից հրապարակված աշխատանքների ավելի քան 91,692 օրինակ, մինչդեռ Common Crawl-ի վրա հիմնված տվյալների բազան ներառում էր ավելի քան 2 միլիոն փաստաթուղթ nytimes.com-ից: Ընկերությունները նաև ենթադրաբար տվյալներ են հավաքել "Project Taxi" և "Project Mango" նախագծերի միջոցով, որոնցից վերջինը պարունակում էր առնվազն 160,903 եզակի աշխատանք լրատվական հրատարակիչներից:techcrunch
Փաստաթղթերում նկարագրվում է, թե ինչպես են OpenAI-ի աշխատակիցները հնարել վճարովի պատնեշները (paywall) շրջանցելու մեթոդներ՝ առանց հայտնաբերվելու: Երբ հետազոտող Նիկ Ռայդերը Բրոքմանին պատմել է "nytimes-ի վճարովի պատնեշը շրջանցելու հաքի" մասին, Բրոքմանը պատասխանել է. "ա՜, լավ է": Աշխատակիցները նաև ենթադրաբար հեռացրել են հեղինակային իրավունքի մասին ծանուցումները տվյալների բազաներից, քանի որ հետազոտողները "չէին ցանկանա, որ մոդելը արտածի" նման ծանուցումներ օգտատերերի համար:techcrunch
Այս խոստովանությունները կարող են խաթարել OpenAI-ի պաշտպանական դիրքերը, հատկապես այն պահանջի առումով, որ օգտագործումը չպետք է վնասի օրիգինալ աշխատանքի շուկային: Նադելան ինքը ցուցմունք է տվել, որ "ամեն ինչ, ինչ վճարովի է, պետք է լիցենզավորվի ցանկացածի կողմից, ով ցանկանում է օգտագործել այն… ուսուցման համար": TechCrunch-ի հաղորդմամբ՝ այս ամսվա սկզբին Թրամփի վարչակազմը միջնորդություն է ներկայացրել՝ ի պաշտպանություն OpenAI-ի կողմից հեղինակային իրավունքով պաշտպանված նյութերի չարտոնված օգտագործման: OpenAI-ն և Microsoft-ը մեկնաբանության խնդրանքին չեն պատասխանել:techcrunch