Newsletter Subscribe
Enter your email address below and subscribe to our newsletter
[forminator_form id="25163"]
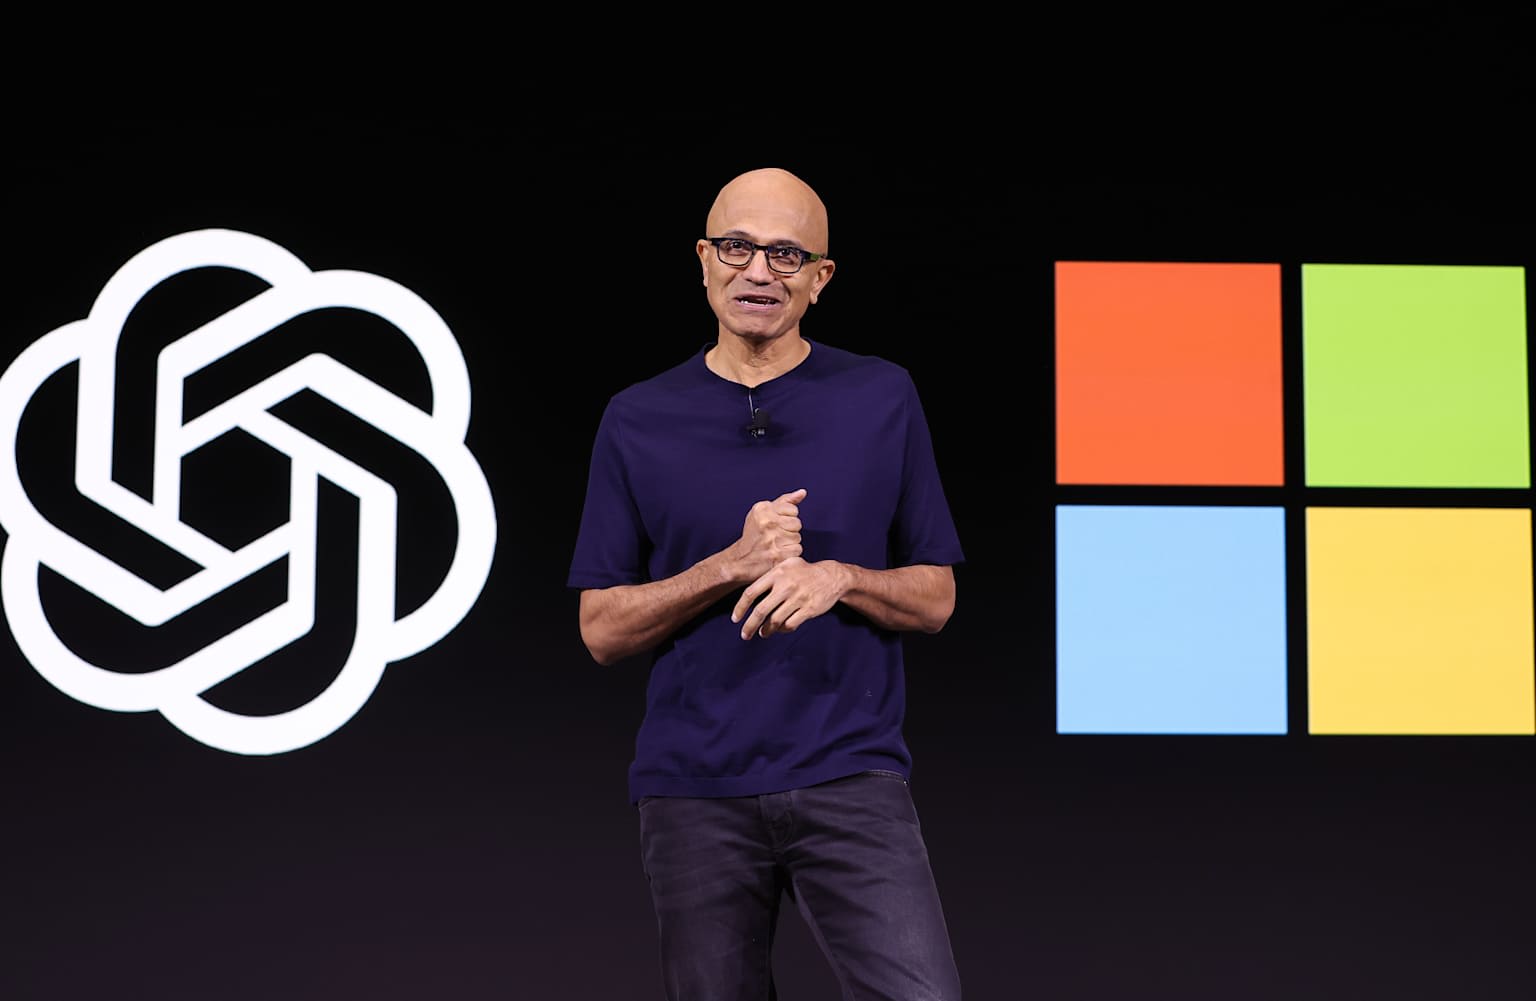
techcrunchtechcrunchtechcrunchNew York Times-ის მიერ OpenAI-სა და Microsoft-ის წინააღმდეგ მიმდინარე საავტორო უფლებების დავის ფარგლებში გასაჯაროებული დოკუმენტები ცხადყოფს, რომ ორივე კომპანიის მაღალი რანგის მენეჯერები პირად საუბრებში აღიარებდნენ, რომ მათი AI-ის წვრთნის პრაქტიკა ქურდობის ტოლფასია და ეგზისტენციალურ საფრთხეს უქმნის იმ გამომცემლებს, რომელთა ნამუშევრებიც მათ მოდელებს კვებავს.
ხუთშაბათს გასაჯაროებული დოკუმენტები აჩვენებს, რომ Microsoft-ის გამოყენებითი მეცნიერების დირექტორმა ბრენტ ჰეხტმა 2023 წლის იანვრის შიდა მემორანდუმში კომპანიების მიერ ახალი ამბების მასობრივად შეგროვებას "უპრეცედენტო მასშტაბის გასაოცარი ქურდობა" და "ადამიანის ისტორიაში შრომის უდიდესი ქურდობა" უწოდა. 2024 წლის იანვრის პრეზენტაციაში ჰეხტმა გააფრთხილა, რომ Microsoft-ის AI-ზე დაფუძნებულმა მიდგომამ შექმნა "განწირულობის მარყუჟი", რომელიც "დააზიანებს როგორც ჩვენი მოდელების მუშაობას, ისე მთლიანად ინტერნეტს".wsj+1
Microsoft-ის საკუთარმა მონაცემებმა აჩვენა, რომ მისმა Copilot-მა Times-ის დომენზე გადასვლების მაჩვენებელი 93%-ით შეამცირა ტრადიციულ Bing-ის ძიებასთან შედარებით. OpenAI-ის ChatGPT-ის ხელმძღვანელმა ნიკ ტერლიმ შიდა მიმოწერაში დაწერა, რომ გამომცემლები "ეგზისტენციალური საფრთხის" წინაშე დგანან ისეთი პროდუქტების გამო, როგორიცაა ჩეთბოტი, რომელიც, მისი თქმით, "დიდწილად შემცვლელია". OpenAI-ის პრეზიდენტმა გრეგ ბროკმანმა მოდელებს "ახალი ამბების კუთხით შესანიშნავი" უწოდა, ხოლო Microsoft-ის აღმასრულებელმა დირექტორმა სატია ნადელამ ფიცის ქვეშ ჩვენებაში აღიარა, რომ ჩეთბოტებთან საუბარი "ანაცვლებს ინფორმაციის მიღებას პირდაპირ ვებსაიტზე, ნაცვლად იმისა, რომ მომხმარებელი გადავიდეს პირველწყაროზე".techcrunch
დოკუმენტები პირველად ამხელს სავარაუდო კოპირების მასშტაბს: მხოლოდ OpenAI-ის წვრთნის შუალედური მონაცემთა ბაზები შეიცავდა Times-ის, Daily News-ისა და საგამოძიებო ჟურნალისტიკის ცენტრის მიერ გამოქვეყნებული ნამუშევრების 91,692-ზე მეტ ასლს, ხოლო Common Crawl-ზე დაფუძნებული მონაცემთა ბაზა მოიცავდა 2 მილიონზე მეტ დოკუმენტს nytimes.com-დან. კომპანიები ასევე სავარაუდოდ აგროვებდნენ მონაცემებს პროექტების, "Project Taxi"-სა და "Project Mango"-ს მეშვეობით, სადაც მეორე მათგანი შეიცავდა მინიმუმ 160,903 უნიკალურ ნამუშევარს საინფორმაციო გამომცემლებისგან.techcrunch
დოკუმენტებში აღწერილია, თუ როგორ იგონებდნენ OpenAI-ის თანამშრომლები ფასიანი ბარიერების (paywall) გვერდის ავლის მეთოდებს ისე, რომ არ გამოვლენილიყვნენ. როდესაც მკვლევარმა ნიკ რაიდერმა ბროკმანს უთხრა "nytimes-ის ფასიანი ბარიერის გვერდის ავლის ჰაკის" შესახებ, ბროკმანმა უპასუხა: "აჰ, კარგია". თანამშრომლები ასევე სავარაუდოდ შლიდნენ საავტორო უფლებების შესახებ შეტყობინებებს მონაცემთა ბაზებიდან, რადგან მკვლევარებს "არ სურდათ, რომ მოდელს გამოეტანა" ასეთი შეტყობინებები მომხმარებლებისთვის.techcrunch
ამ აღიარებამ შესაძლოა შეარყიოს OpenAI-ის დაცვის სტრატეგია, განსაკუთრებით იმ მოთხოვნის კუთხით, რომ გამოყენებამ არ უნდა დააზიანოს ორიგინალური ნამუშევრის ბაზარი. ნადელამ თავად მისცა ჩვენება, რომ "ყველაფერი, რაც ფასიანია, უნდა იყოს ლიცენზირებული ნებისმიერის მიერ, ვისაც სურს მისი გამოყენება… წვრთნისთვის". TechCrunch-ის ცნობით, ამ თვის დასაწყისში ტრამპის ადმინისტრაციამ შეიტანა შუამდგომლობა OpenAI-ის მიერ საავტორო უფლებებით დაცული მასალის არალიცენზირებული გამოყენების დასაცავად. OpenAI-სა და Microsoft-ს კომენტარისთვის მიმართვის საპასუხოდ კომენტარი არ გაუკეთებიათ.techcrunch