Newsletter Subscribe
Enter your email address below and subscribe to our newsletter
[forminator_form id="25163"]

All voices matter
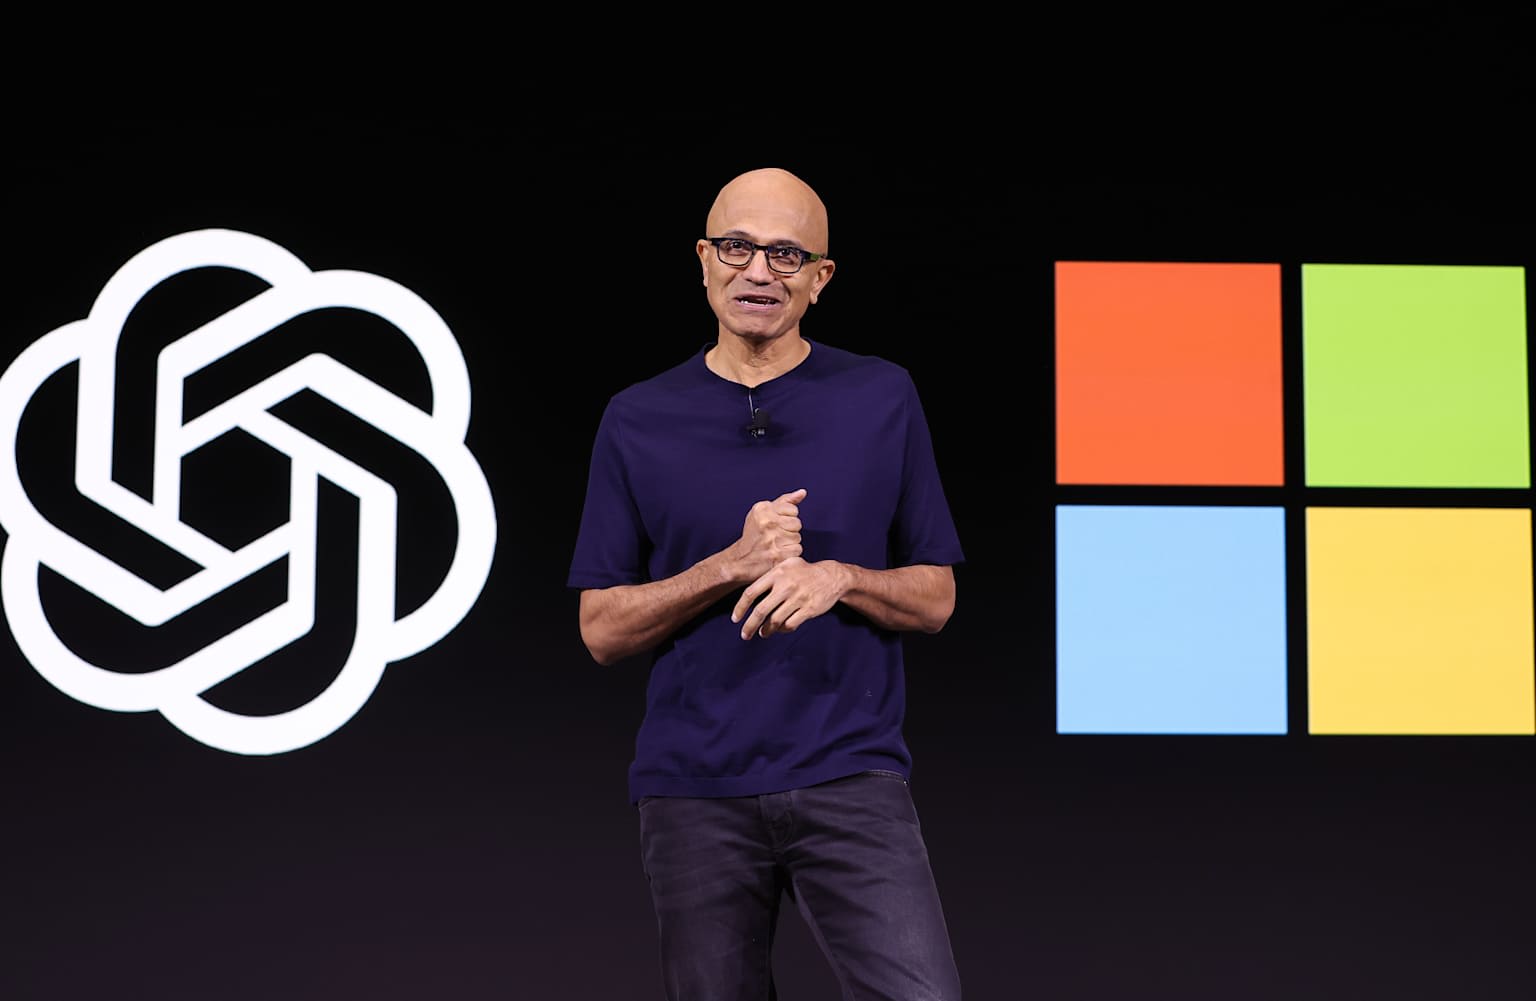
techcrunchtechcrunchtechcrunchNeu entsiegelte Unterlagen im drei Jahre alten Urheberrechtsstreit der New York Times gegen OpenAI und Microsoft enthüllen, dass leitende Angestellte beider Unternehmen privat einräumten, dass ihre Praktiken beim KI-Training einem Diebstahl gleichkamen und eine existenzielle Bedrohung für die Verlage darstellten, deren Arbeit ihre Modelle antrieb.
Die am Donnerstag veröffentlichten Dokumente zeigen, dass Microsofts Director of Applied Science, Brent Hecht, das massenhafte Scraping von Nachrichteninhalten durch die Unternehmen in einem internen Memo vom Januar 2023 als "einen erstaunlichen Diebstahl von beispiellosem Ausmaß" und "den größten Arbeitsdiebstahl der Menschheitsgeschichte" bezeichnete. In einer separaten Präsentation vom Januar 2024 warnte Hecht, dass Microsofts KI-gesteuerter Ansatz eine "Todesspirale" geschaffen habe, die "die Leistung unserer Modelle und das gesamte Web gleichzeitig schädigen würde".wsj+1
Microsofts eigene Daten zeigten, dass die Copilot-Antwortmaschine die Klickraten für die Domain der Times um bis zu 93 % im Vergleich zur herkömmlichen Bing-Suche senken ließ. Der Leiter von OpenAIs ChatGPT, Nick Turley, schrieb intern, dass Verlage durch Produkte wie den Chatbot, den er als "weitgehend substitutiv" beschrieb, vor einer "existenziellen Bedrohung" stünden. OpenAI-Präsident Greg Brockman nannte die Modelle "exzellent bei Nachrichten", während Microsoft-CEO Satya Nadella unter Eid aussagte, dass Unterhaltungen mit Chatbots "das Bereitstellen der Informationen direkt auf der Website der KI-Plattform ersetzt haben, anstatt zur zugrunde liegenden Quelle gehen zu müssen".techcrunch
Die Unterlagen enthüllen erstmals das Ausmaß des mutmaßlichen Kopierens: Allein die Trainingsdatensätze von OpenAI enthielten mehr als 91 692 Kopien von Werken, die von der Times, der Daily News und dem Center for Investigative Reporting veröffentlicht wurden, während ein von Common Crawl abgeleiteter Datensatz mehr als 2 Millionen Dokumente von nytimes.com enthielt. Die Unternehmen sollen Trainingsdaten auch durch Initiativen namens Project Taxi und Project Mango zusammengestellt haben, wobei letzteres Kopien von mindestens 160 903 einzigartigen Werken der Nachrichtenverlage enthielt.techcrunch
Die Unterlagen beschreiben, wie OpenAI-Mitarbeiter angeblich Methoden entwickelten, um Bezahlschranken unbemerkt zu umgehen. Als der Forscher Nick Ryder Brockman von einem "Hack zur Umgehung der nytimes-Bezahlschranke" berichtete, antwortete Brockman: "ah nice". Mitarbeiter sollen zudem Urheberrechtshinweise aus Trainingsdaten entfernt haben, da Forscher "nicht wollten, dass das Modell solche Hinweise an Benutzer ausgibt".techcrunch
Die Eingeständnisse könnten die "Fair Use"-Verteidigung von OpenAI untergraben, insbesondere die Anforderung, dass die Nutzung den Markt für das Originalwerk nicht schädigt. Nadella selbst sagte aus, dass "alles, was hinter einer Bezahlschranke liegt, von jedem lizenziert werden sollte, der es nutzen möchte… für Grounding oder Training". Anfang des Monats reichte die Trump-Administration laut TechCrunch einen Schriftsatz zur Verteidigung der unlizenzierten Nutzung von urheberrechtlich geschütztem Material durch OpenAI ein. OpenAI und Microsoft reagierten nicht auf Anfragen um Stellungnahme.techcrunch