Newsletter Subscribe
Enter your email address below and subscribe to our newsletter
[forminator_form id="25163"]

All voices matter
techcrunchtechcrunchtechcrunchNuevos documentos desclasificados en la demanda por derechos de autor que el New York Times mantiene desde hace tres años contra OpenAI y Microsoft revelan que altos ejecutivos de ambas empresas reconocieron en privado que sus prácticas de entrenamiento de IA equivalían a un robo y representaban una amenaza existencial para los editores cuyo trabajo impulsaba sus modelos.
Los documentos, hechos públicos el jueves, muestran que el Director de Ciencia Aplicada de Microsoft, Brent Hecht, describió el scraping masivo de contenido de noticias como "un robo asombroso de proporciones sin precedentes" y "el mayor robo de trabajo en la historia de la humanidad" en un memorando interno de enero de 2023. En una presentación separada de enero de 2024, Hecht advirtió que el enfoque de IA de Microsoft había creado un "bucle de fatalidad" que "dañaría el rendimiento de nuestros modelos y de toda la web al mismo tiempo".wsj+1
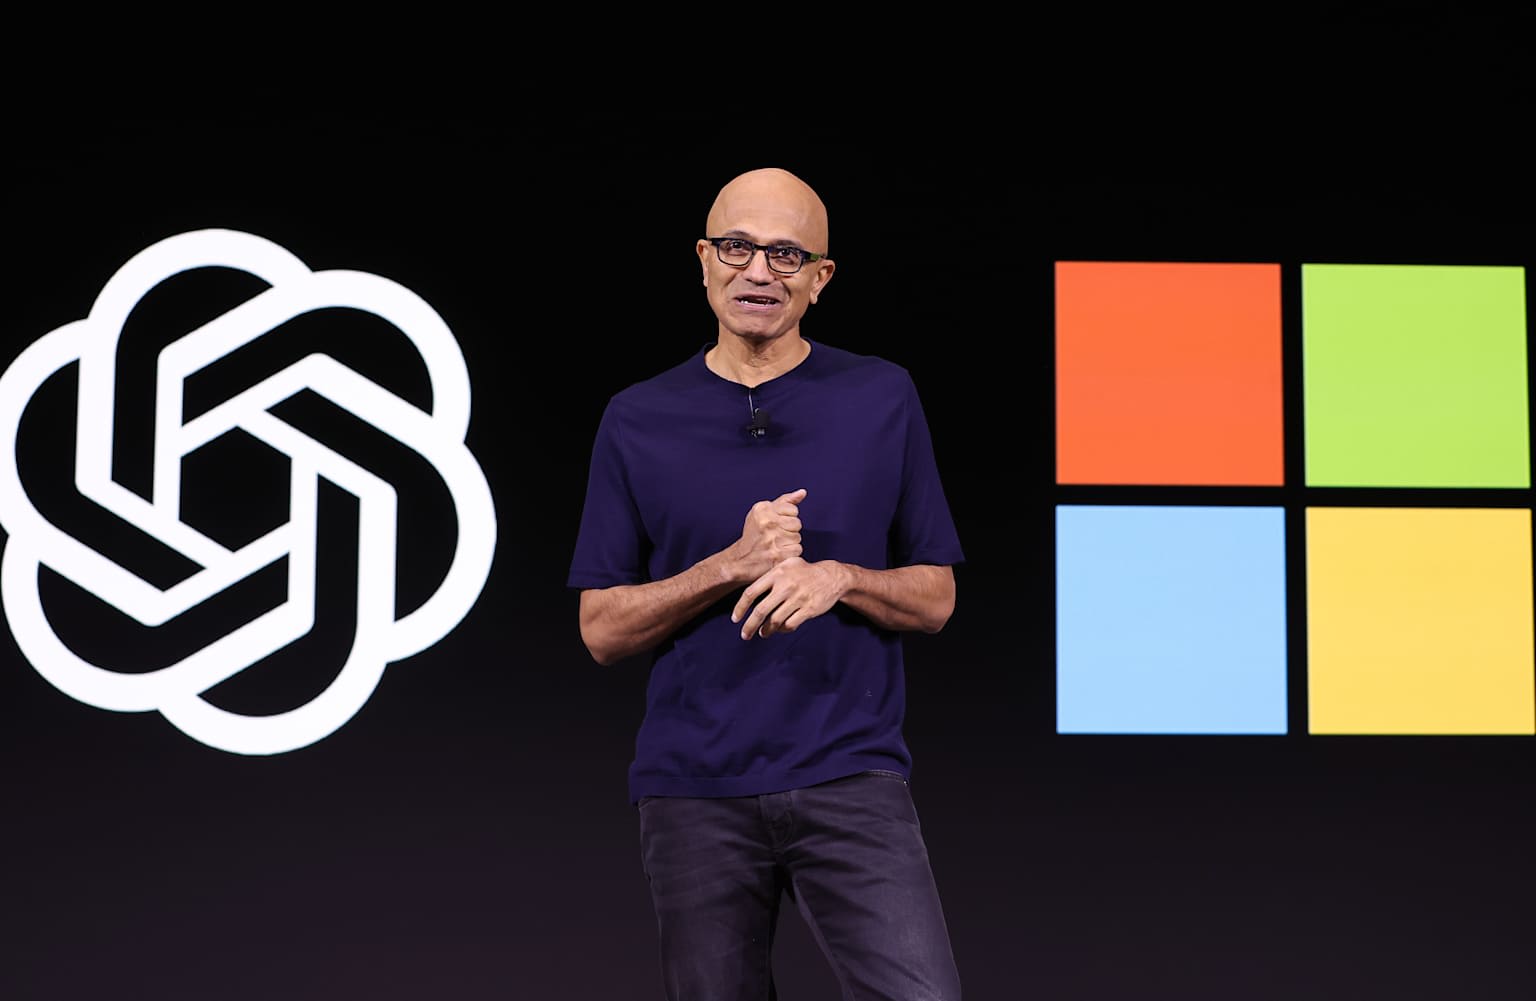
Los datos de Microsoft mostraron que su "motor de respuestas" Copilot provocó que las tasas de clics hacia el dominio del Times cayeran hasta un 93% en comparación con la búsqueda tradicional de Bing. El jefe de ChatGPT de OpenAI, Nick Turley, escribió internamente que los editores enfrentan una "amenaza existencial" por productos como el chatbot, al que describió como "sustitutivo en gran medida". El presidente de OpenAI, Greg Brockman, calificó los modelos como "excelentes para las noticias", mientras que el CEO de Microsoft, Satya Nadella, testificó bajo juramento que conversar con chatbots "ha sustituido… darte la información directamente en el sitio web en la plataforma de IA frente a la necesidad de ir a la fuente original".techcrunch
Los documentos revelan por primera vez la escala de la supuesta copia: los conjuntos de datos de entrenamiento intermedio de OpenAI contenían por sí solos más de 91,692 copias de obras publicadas por el Times, el Daily News y el Center for Investigative Reporting, mientras que un conjunto de datos derivado de Common Crawl incluía más de 2 millones de documentos de nytimes.com. Las empresas también habrían reunido datos de entrenamiento a través de iniciativas llamadas Project Taxi y Project Mango, esta última conteniendo copias de al menos 160,903 obras únicas de los editores de noticias.techcrunch
Los documentos describen cómo los empleados de OpenAI supuestamente idearon métodos para eludir los muros de pago sin ser detectados. Cuando el investigador Nick Ryder le contó a Brockman sobre un "truco para saltarse el muro de pago del nytimes", Brockman respondió: "ah, bien". Los empleados también habrían eliminado los avisos de derechos de autor de los datos de entrenamiento, ya que los investigadores "no querrían que el modelo mostrara" dichos avisos a los usuarios.techcrunch
Las admisiones podrían socavar la defensa de uso legítimo de OpenAI, particularmente el requisito de que el uso no dañe el mercado de la obra original. El propio Nadella testificó que "cualquier cosa que esté bajo muro de pago debería ser licenciada por cualquiera que quiera usarla… para fundamentación o entrenamiento". A principios de este mes, la administración Trump presentó un escrito en defensa del uso sin licencia de material protegido por derechos de autor por parte de OpenAI, según TechCrunch. OpenAI y Microsoft no respondieron a las solicitudes de comentarios.techcrunch