Newsletter Subscribe
Enter your email address below and subscribe to our newsletter
[forminator_form id="25163"]

All voices matter
blogs.nvidia.com.developer.nvidia.com.blogs.nvidia.com+1.Nvidia a ajouté jeudi 15 octobre trois modèles à poids ouverts à sa famille Nemotron. Le produit phare est Nemotron 3.5 Super VL, un modèle multimodal de 120 milliards de paramètres destiné aux "agents spécialisés toujours actifs". Il est accompagné de deux modèles de périphérie, Nemotron 3.5 Bolt 74B-A9B 24 Go et Nemotron 3.5 Bolt E4B 4 Go, a déclaré Nvidia. Ensemble, ces modèles sont conçus pour faire fonctionner des agents d'IA sur tout type de support, des systèmes de centres de données aux ordinateurs de bureau, a rapporté Yahoo Finance. Super VL et Bolt 74B-A9B sont disponibles dès maintenant, et Bolt E4B est attendu pour le 23 octobre.developer.nvidia.com+1
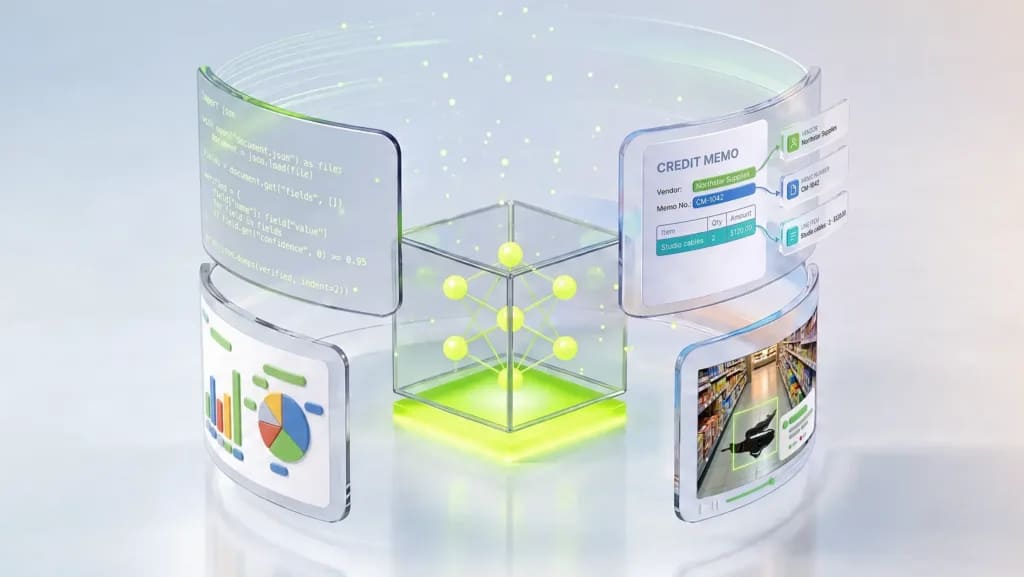
Super VL utilise une conception de mélange d'experts qui active 12 milliards de ses 120 milliards de paramètres par jeton. Il traite le texte, les images, les documents et la vidéo dans un seul modèle, selon le blog des développeurs de Nvidia. Nvidia affirme que le modèle offre un débit jusqu'à cinq fois supérieur sur les tâches d'agent par rapport à d'autres modèles ouverts de même taille lorsqu'il est exécuté sur un seul GPU. Il indique également que Super VL a obtenu un score de 80,8 % sur le benchmark de raisonnement graphique CharXiv.developer.nvidia.com
Le modèle a été distillé à partir de Nemotron 3 Ultra, et les entreprises peuvent le post-entraîner sur leurs propres données. Nvidia a cité quelques premiers utilisateurs. Scale AI s'attend à ce que les coûts d'inférence pour une charge de travail de crédit fournisseur chutent de 40 fois, et Ramp prévoit une latence jusqu'à 10 fois inférieure pour la lecture des reçus. Super VL est proposé sur Hugging Face, OpenRouter, ModelScope et en tant que microservice Nvidia NIM.blogs.nvidia.com+1
Bolt 74B-A9B possède 74 milliards de paramètres et en utilise 9 milliards par jeton. La quantification à deux bits lui permet de tenir dans 24 Go de mémoire. Comme les autres modèles Nemotron, ses poids, ses données d'entraînement et ses recettes sont entièrement ouverts, a déclaré Nvidia. Il fonctionne via llama.cpp, Ollama, LM Studio, Unsloth et vLLM. Nvidia l'a conçu pour ses ordinateurs portables RTX Spark, qui seront mis en vente le vendredi 16 octobre. Bolt E4B est conçu pour les agents physiques et conversationnels, tels que les assistants vocaux et les personnages de jeux interactifs, sur le matériel GeForce RTX, Jetson et DGX Spark.blogs.nvidia.com+1
Les modèles à poids ouverts font désormais partie de la stratégie de croissance de Nvidia. Des modèles moins coûteux peuvent inciter davantage d'organisations à adopter l'IA, ce qui pourrait à son tour stimuler la demande de puces à long terme, a noté Yahoo Finance. Des développeurs chinois tels que Moonshot AI et Alibaba mènent actuellement la discussion sur les modèles ouverts avec leurs familles Kimi et Qwen. Le PDG Jensen Huang a exhorté les entreprises américaines à construire et à adopter davantage de modèles ouverts afin que l'industrie ne reste pas enfermée dans quelques systèmes fermés. ZDNET a qualifié Super VL de "nouvelle avancée pour l'IA à poids ouverts aux États-Unis".zdnet.com+1