Newsletter Subscribe
Enter your email address below and subscribe to our newsletter
[forminator_form id="25163"]

All voices matter
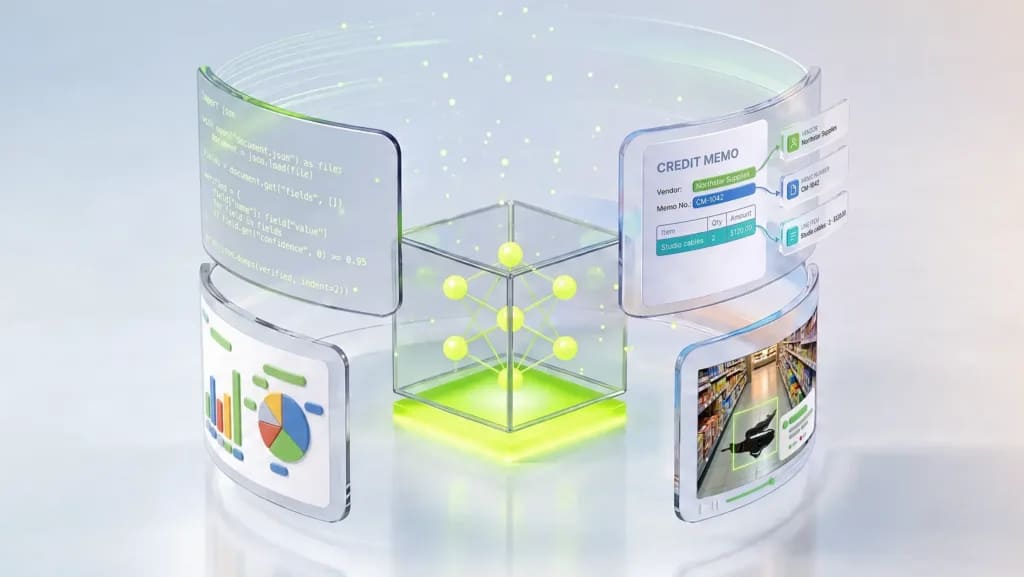
blogs.nvidia.com.developer.nvidia.com.blogs.nvidia.com+1.Nvidia añadió el jueves 15 de octubre tres modelos de peso abierto a su familia Nemotron. El buque insignia es Nemotron 3.5 Super VL, un modelo multimodal de 120 mil millones de parámetros para "agentes especializados siempre activos". Viene con dos modelos de borde, Nemotron 3.5 Bolt 74B-A9B de 24GB y Nemotron 3.5 Bolt E4B de 4GB, señaló Nvidia. En conjunto, los modelos están destinados a ejecutar agentes de IA en todo tipo de dispositivos, desde sistemas de centros de datos hasta computadoras de escritorio, informó Yahoo Finance. Super VL y Bolt 74B-A9B ya están disponibles, y Bolt E4B llegará el 23 de octubre.developer.nvidia.com+1
Super VL utiliza un diseño de mezcla de expertos que activa 12 mil millones de sus 120 mil millones de parámetros por token. Maneja texto, imágenes, documentos y video en un solo modelo, según el blog de desarrolladores de Nvidia. Nvidia afirma que el modelo ofrece hasta cinco veces más rendimiento en tareas de agentes que otros modelos abiertos de su tamaño cuando se ejecuta en una sola GPU. También indica que Super VL obtuvo un 80.8% en el benchmark de razonamiento de gráficos CharXiv.developer.nvidia.com
El modelo fue destilado de Nemotron 3 Ultra, y las empresas pueden realizar un entrenamiento posterior con sus propios datos. Nvidia destacó algunos usuarios iniciales. Scale AI espera que los costos de inferencia para una carga de trabajo de crédito de proveedor caigan 40 veces, y Ramp espera una latencia hasta 10 veces menor para la lectura de recibos. Super VL se ofrece en Hugging Face, OpenRouter, ModelScope y como un microservicio Nvidia NIM.blogs.nvidia.com+1
Bolt 74B-A9B tiene 74 mil millones de parámetros y utiliza 9 mil millones de ellos por token. La cuantización de dos bits le permite caber en 24GB de memoria. Al igual que otros modelos Nemotron, sus pesos, datos de entrenamiento y recetas son totalmente abiertos, dijo Nvidia. Se ejecuta a través de llama.cpp, Ollama, LM Studio, Unsloth y vLLM. Nvidia lo construyó para sus portátiles RTX Spark, que salen a la venta el viernes 16 de octubre. Bolt E4B está diseñado para agentes físicos y conversacionales, como asistentes de voz y personajes de juegos interactivos, en hardware GeForce RTX, Jetson y DGX Spark.blogs.nvidia.com+1
Los modelos de peso abierto se han convertido en parte de la estrategia de crecimiento de Nvidia. Los modelos más económicos pueden atraer a más organizaciones a la IA, lo que a su vez podría aumentar la demanda de chips a largo plazo, señaló Yahoo Finance. Desarrolladores chinos como Moonshot AI y Alibaba lideran actualmente la conversación sobre modelos abiertos con sus familias Kimi y Qwen. El CEO Jensen Huang ha instado a las empresas estadounidenses a construir y adoptar más modelos abiertos para que la industria no quede encerrada en unos pocos sistemas cerrados. ZDNET calificó a Super VL como "otro paso adelante para la IA de peso abierto de EE. UU."zdnet.com+1