



Newsletter Subscribe
Enter your email address below and subscribe to our newsletter
[forminator_form id="25163"]

All voices matter
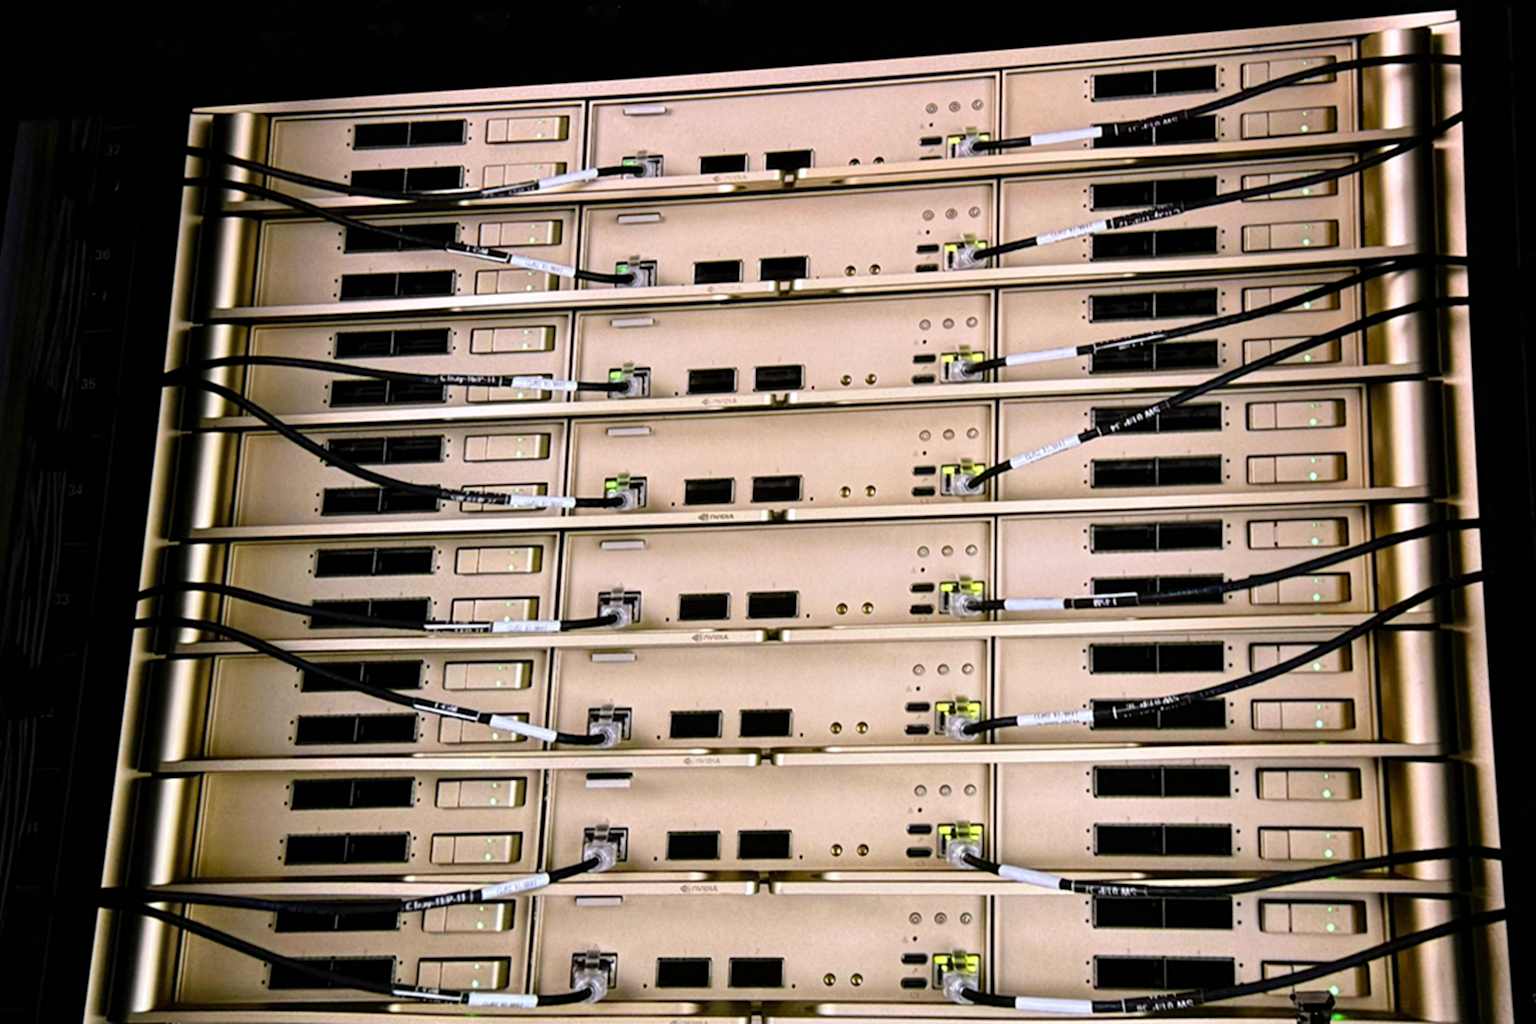
blogs.nvidia+1blogs.nvidiapulse2Nvidia veröffentlichte am Montag Leistungsdaten, die zeigen, dass die Vera Rubin NVL72-Plattform der nächsten Generation bei agentenbasierten KI-Workloads einen bis zu 30-mal höheren Inferenz-Durchsatz pro Megawatt liefert als das aktuelle GB300 NVL72-System, während die Kosten pro Million Token um das bis zu 35-fache gesenkt werden. Gleichzeitig präsentierte das Unternehmen die Architektur seiner neuen Vera-CPU auf der Konferenz Hot Chips 2026 und führte Scale-In als fünfte Säule seiner KI-Netzwerkinfrastruktur ein.
Die Durchsatzwerte wurden mithilfe des SemiAnalysis AgentX-Benchmarks gemessen, der reale agentenbasierte Coding-Sitzungen einschließlich Kontextwachstum, Tool-Aufrufen und der Erstellung von Unteragenten erfasst. Beim Ausführen des DeepSeek V4 Pro-Modells erreichte Vera Rubin NVL72 die 30-fache Verbesserung gegenüber dem GB300 NVL72, das selbst bereits einen bis zu 15-mal besseren Durchsatz pro Megawatt liefert als die vorherige Hopper-Architektur. Die Ergebnisse warten noch auf die Überprüfung durch SemiAnalysis und spiegeln die Vera-CPU-Leistung für Tool-Aufrufe noch nicht wider.blogs.nvidia+1
Diese Fortschritte sind entscheidend, da agentenbasierte Arbeitslasten laut von Nvidia zitierten OpenRouter-Daten etwa 15-mal mehr Token verbrauchen als eine einfache Chat-Anfrage. In Kombination mit der DSX MaxLPS-Energiemanagement-Technologie von Nvidia, die bis zu 40 Prozent mehr GPUs innerhalb desselben Megawatt-Budgets bereitstellen kann, adressiert die Plattform einen grundlegenden Engpass für Betreiber von KI-Rechenzentren: wie viel nützliche Arbeit jedes verfügbare Megawatt leisten kann.developer.nvidia+1
Auf der Hot Chips 2026 erläuterte Nvidia das 88-Kern-Design der Vera-CPU, das auf der kundenspezifischen Olympus-Kernarchitektur basiert. Der Chip priorisiert Single-Thread-Leistung und niedrige Latenz gegenüber der reinen Kernanzahl, was einen Bruch mit dem Branchentrend hin zu schwächeren, aber zahlreicheren Kernen darstellt. Vera verfügt über ein 10-breites Dekodierungs-Frontend, räumliches Multithreading, acht LPDDR5X-Speichercontroller mit einer Bandbreite von bis zu 1,2 TB/s und eine Sechs-Die-Konstruktion mit NVLink-C2C-Verbindung.nvidianews.nvidia+1
"Agentenbasierte KI erfordert eine neue Art von Rechensystem, das nicht nur darauf ausgelegt ist, Antworten zu generieren, sondern auch zu handeln", sagte Ian Buck, Vizepräsident für Hyperscale und High-Performance Computing bei Nvidia.nvidianews.nvidia
Nvidia führte zudem die Scale-In-Netzwerkinfrastruktur als fünfte Säule seines KI-Netzwerks ein, die von BlueField-4 DPUs angetrieben wird und darauf ausgelegt ist, agentenbasierte KI-Fabriken in großem Maßstab zu sichern, zu verwalten und zu betreiben. Die Ankündigung ergänzt die bestehenden Säulen von Nvidia für Scale-Up, Scale-Out, Scale-Across und Storage-Networking.developer.nvidia
In einer separaten Ankündigung gab SpaceXAI bekannt, dass das Unternehmen Vera-CPUs in seiner KI-Infrastruktur für Grok einsetzen und ein optimiertes Vera Rubin NVL72-System an Bord seines Starmind KI-Satelliten der ersten Generation in den Orbit bringen will.nvidianews.nvidia


