



Newsletter Subscribe
Enter your email address below and subscribe to our newsletter
[forminator_form id="25163"]

All voices matter
Un modèle suspecté d'être la prochaine génération d'IA phare d'Alphabet Inc., Gemini 4 Pro, est apparu sur la plateforme de benchmark Arena sous le nom "gemini-3.8-flash", selon des rapports de développeurs ayant commencé à circuler le 17 septembre. Le modèle,…
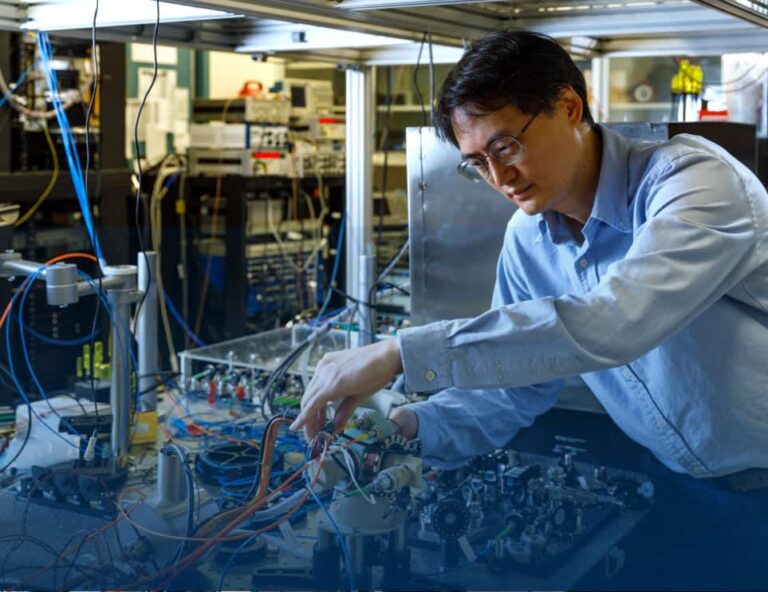
Les ordinateurs quantiques actuels restent environ cinq ordres de grandeur en dessous de la capacité de calcul requise pour résoudre des problèmes scientifiques reconnus, selon une nouvelle étude comparative publiée sur le serveur de prépublication arXiv. Cette conclusion, émanant de…

Les modèles d'IA Claude d'Anthropic occupent les premières places sur toutes les variantes majeures du benchmark de codage SWE-bench en septembre 2026, Claude Opus 5 atteignant 96 % sur SWE-bench Verified et Claude Fable 5.1 obtenant 81,2 % sur le…

OpenAI a commencé le déploiement de GPT-6 Astra le 3 septembre, le qualifiant de "modèle le plus intelligent et le plus aligné au monde", avec des capacités couvrant la navigation, le codage, la cybersécurité et le raisonnement scientifique. Mais les…