



Newsletter Subscribe
Enter your email address below and subscribe to our newsletter
[forminator_form id="25163"]

All voices matter
En modell som misstänks vara Googles nästa flaggskepp inom AI, Gemini 4 Pro från Alphabet Inc., har dykt upp på benchmark-plattformen Arena under namnet "gemini-3.8-flash", enligt utvecklarrapporter som började cirkulera den 17 september. Modellen, som bär det interna kodnamnet Argon,…
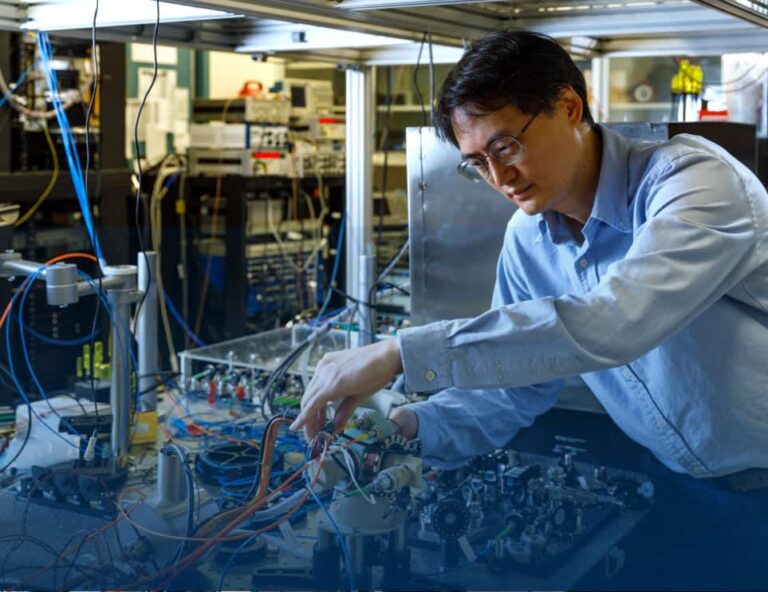
Dagens kvantdatorer ligger fortfarande cirka fem storleksordningar under den beräkningskapacitet som krävs för att ta sig an etablerade vetenskapliga problem, enligt en ny benchmarkingstudie publicerad på preprint-servern arXiv. Upptäckten, från forskare vid Sandia National Laboratories med bidrag från Quantinuum och…

Anthropics Claude AI-modeller innehar toppositionerna i varje större variant av kodningstestet SWE-bench per september 2026, där Claude Opus 5 når 96 procent på SWE-bench Verified och Claude Fable 5.1 får 81,2 procent på det mer krävande SWE-bench Pro. Resultaten understryker…

OpenAI påbörjade utrullningen av GPT-6 Astra den 3 september och kallade den "världens mest intelligenta och anpassade modell" med förmågor inom surfning, kodning, cybersäkerhet och vetenskaplig resonemang. Men oberoende benchmark-utvärderingar som publicerades dagar senare av Artificial Analysis placerar Astra på…