Newsletter Subscribe
Enter your email address below and subscribe to our newsletter
[forminator_form id="25163"]

All voices matter
already-clean.goodfire.com.already-clean.goodfire.com.the-decoder.de+1.Nick Cammarata, en forsker ved AI-tolkbarhetslaboratoriet Goodfire, argumenterer i et essay publisert 15. oktober for at nevrale nettverk er langt lettere å lese enn det feltet hittil har antatt. Han mener feltets mest kjente bevis for "superposisjon" har blitt feiltolket. Essayet har skapt splid blant forskere om hvorvidt tolkbarhet er nær et gjennombrudd. Cammarata kaller sin påstand "en arbeidshypotese". En teknisk tilleggsartikkel om nevroner i språkmodeller er ifølge essayet ennå ikke publisert.braindetox.kr
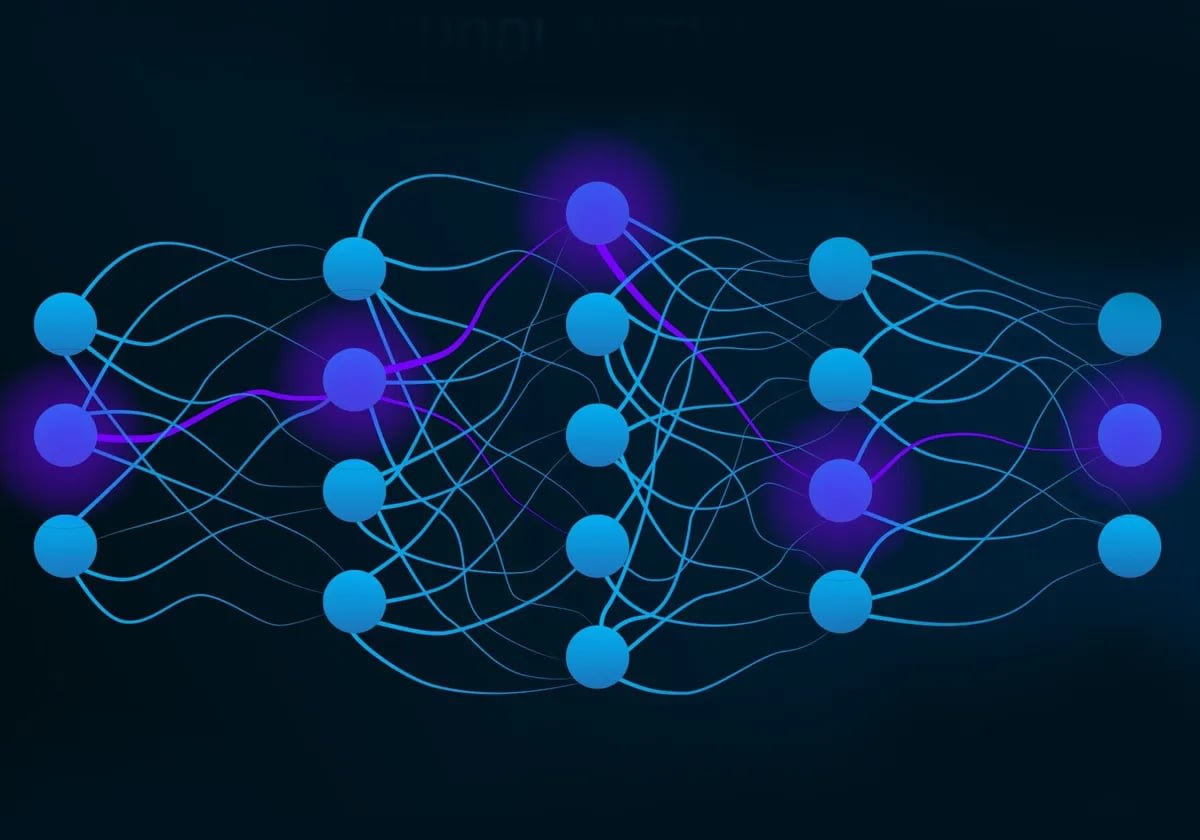
Under superposisjonsteorien pakker et nettverk som mangler nevroner, urelaterte konsepter inn i de samme nevronene. Forskere ville da trenge en sekundær modell, som en «sparse autoencoder», for å nøste dem opp før videre studier. Cammarata argumenterer i stedet for at de fleste nevroner som ser blandede ut, stammer fra det han kaller "rekursiv generalisering". Et nevron utvikler utløpere relatert til hovedoppgaven sin, slik en gren vokser ut undergrener. Hans eksempel er et nevron som gikk fra å detektere "iy" til "diy" til "do it yourself". "Jeg tenker nå at jeg gjorde superposisjon til nullhypotesen når det burde vært den siste hypotesen, ettersom det er den mest radikale og minst testbare," skriver han.already-clean.goodfire.com
Essayet tar også for seg tidligere arbeid Cammarata selv har gjort. Han sier at det berømte "katt og bil"-nevronet i bildemodellen InceptionV1 egentlig er en detektor for spisse V-former. Han sier også at bil-til-hund-superposisjonskretsen han identifiserte i 2020 var en feil.the-decoder.de
Cammarata sammenlignet InceptionV1 med en ConvNeXt-modell av samme størrelse trent på samme data. Rundt 99 % av nevronene i det siste laget til ConvNeXt-modellen var lett tolkbare, rapporterer han. I InceptionV1 var tallet omtrent 5 % med datidens verktøy, og rundt 50 % med dagens verktøy. For språkmodeller skriver han at "i foreløpige revisjoner av Qwen3-32B anslår vi at omtrent 90 % av nevronpolene har én hovedoppgave." Ytterligere 7 % har to relaterte oppgaver, og 2 % til 4 % er ennå ikke forstått.already-clean.goodfire.com
Han advarer om at tallene avhenger av hvor terskelverdiene settes. Han sier han er "kanskje 85 % sikker" på at nesten alt stammer fra vanlig generalisering. Arbeidet baserte seg på AI-agenter som skriver forklaringer på hva nevroner gjør og deretter tester dem. Agentene gjennomgikk 100 000 attribusjonsgrafer som sporer hvordan informasjon beveger seg gjennom en modell. Til sammenligning fant et automatisert OpenAI-prosjekt i 2023 at bare rundt 1,7 % av nevronene var forståelige, selv etter deres mest generøse mål.the-decoder.de+1
Noen tok godt imot essayet. Nyhetsbrevet AINews fra Latent Space publiserte det under overskriften "Agents disprove Polysemanticity". Andre var mer forsiktige.latent.space
Neel Nanda, som leder mekanistisk tolkbarhet hos Google DeepMind, kalte arbeidet interessant, men sa at det ikke endrer det store bildet. Han tror fortsatt superposisjon er reelt, delvis fordi språkmodeller lagrer langt flere fakta enn de har nevroner, og han mener svake aktiveringer bærer mange av disse lagrede faktaene. Han tviler på at funn fra små bildemodeller kan overføres til språkmodeller, og han argumenterer for at essayet definerer monosemantikk for generøst. Han forventer også at nevronbasert analyse vil gjøre alvorlige feil og overse mye.the-decoder.de+1
De to er enige om ett punkt: modeller kan representere flere konsepter enn de har dimensjoner. Cammarata bestrider kun ideen om at nettverk pakker helt urelaterte ting sammen tilfeldig. Uavhengige grupper har ennå ikke bekreftet resultatene hans.the-decoder.de