Newsletter Subscribe
Enter your email address below and subscribe to our newsletter
[forminator_form id="25163"]

All voices matter
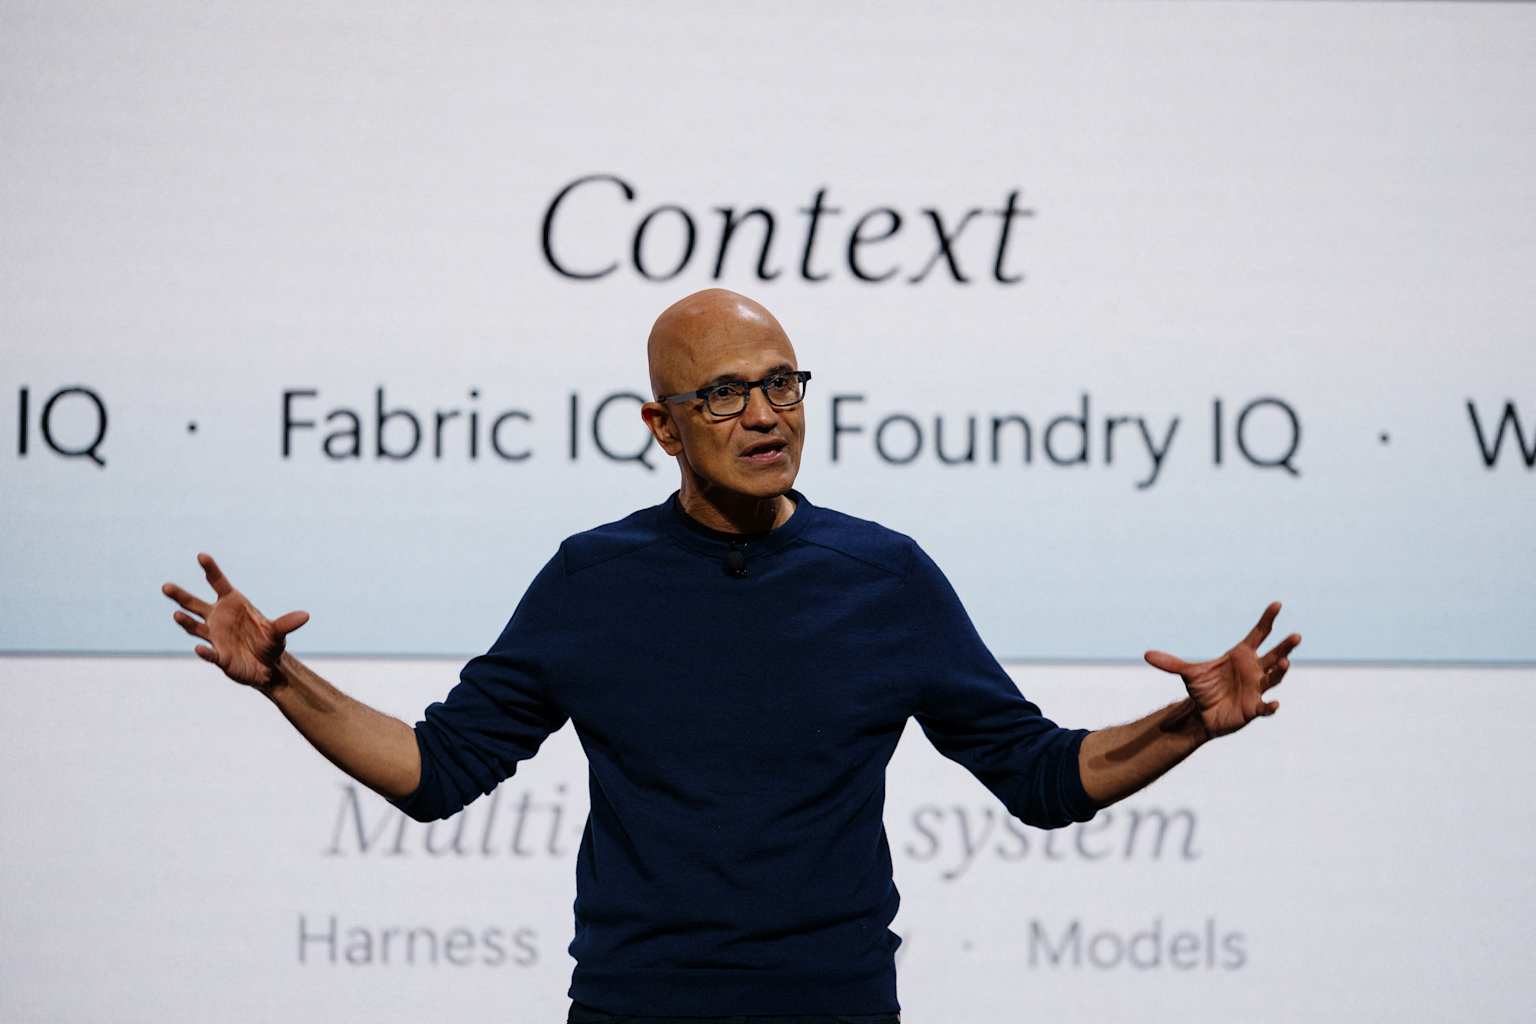
business-standard.com.arstechnica.com+1.techpolicy.press.El CEO de Microsoft, Satya Nadella, calificó la caída global de Microsoft 365 de la semana pasada como "una de esas tormentas perfectas y locas", y reconoció que la empresa debería haber detectado el problema a tiempo. "Por supuesto, deberíamos haber hecho las pruebas antes. Deberíamos haber descubierto cómo implementar mamparos para que no ocurriera una interrupción global", declaró a CNBC el miércoles 18 de noviembre, según Business Standard. Sus comentarios se produjeron mientras empresas y gobiernos calculaban el coste de la interrupción, y antes del informe final de incidentes de Microsoft, previsto para el viernes 20 de noviembre, según Ars Technica.business-standard.com+1
El informe preliminar de Microsoft situó la interrupción entre las 16:20 UTC del 12 de noviembre y las 16:10 UTC del 13 de noviembre, poco menos de 24 horas. El informe clasificó el incidente como "un problema técnico no relacionado con ciberseguridad o IA/agentes", informó Ars Technica. El fallo se atribuyó a un "defecto latente" en una corrección diseñada para los servidores de puerta de enlace de red de Microsoft 365 que comenzó a implementarse en julio, informó Computerworld. Las pruebas de carga de esa corrección se ejecutaron en hardware más débil con menos núcleos que las máquinas de producción, por lo que el error pasó desapercibido, informó The Stack.computerworld.com+2
Otras dos condiciones expusieron el defecto. Unas 15 horas antes de la interrupción, el tráfico de Teams falló y se redirigió a la puerta de enlace que también sirve a Exchange Online, y un problema no relacionado ya había dejado fuera de servicio casi el 14% de la capacidad de esa puerta de enlace. En el peor momento, más del 80% de los servidores de la puerta de enlace habían dejado de responder, informó TechTarget. Durante su intervención en la DealBook Summit de The New York Times, Nadella también advirtió que el descubrimiento de errores mediante IA está empujando a las empresas a parchear más rápido, con menos tiempo de pruebas, lo que podría hacer que los sistemas sean menos estables, informó la Agencia Anadolu.techtarget.com+1
Downdetector Ziff Davis, Inc. registró más de 7,7 millones de informes en las 60 horas posteriores al inicio de la interrupción, y más de 90 países y territorios registraron al menos 1.000 informes cada uno. El investigador de Ookla, Luke Kehoe, escribió en Broadband Breakfast que esto la convirtió en la mayor interrupción en la plataforma desde que Amazon Web Services Amazon.com, Inc. cayó en octubre de 2025. Kehoe argumentó que la interrupción "mostró el riesgo que conlleva compartir dependencias y la concentración".broadbandbreakfast.com
En el Reino Unido, casi todos los fideicomisos del NHS perdieron el correo electrónico, se cancelaron algunas operaciones y se retrasaron casos judiciales, informó Tech Policy Press. El ministro Ian Murray dijo a la Cámara de los Comunes que el incidente "podría haber sido más grave si hubiera durado más tiempo". Los liberal demócratas pidieron un plan para "dejar de depender de unas pocas grandes empresas tecnológicas estadounidenses".techpolicy.press
Restaurar el servicio no puso fin a la interrupción para los usuarios de Outlook. El diseño de "almacenamiento y reenvío" del correo electrónico significó que los servidores externos siguieron poniendo en cola y reintentando los mensajes durante toda la interrupción, y esas acumulaciones pueden tardar "de horas a días" en despejarse, escribió el profesor de la Universidad Estatal de Iowa, Doug Jacobson, en Fortune. Microsoft amplió los tiempos de espera de entrega para que los mensajes retrasados no rebotaran como no entregables. También dijo que ha añadido capacidad y barandillas de distribución de tráfico. El informe preliminar no explicó por qué fallaron las salvaguardas de aislamiento regional, señaló Ars Technica, y la revisión final podría responder a esa pregunta.fortune.com+1