Newsletter Subscribe
Enter your email address below and subscribe to our newsletter
[forminator_form id="25163"]

All voices matter
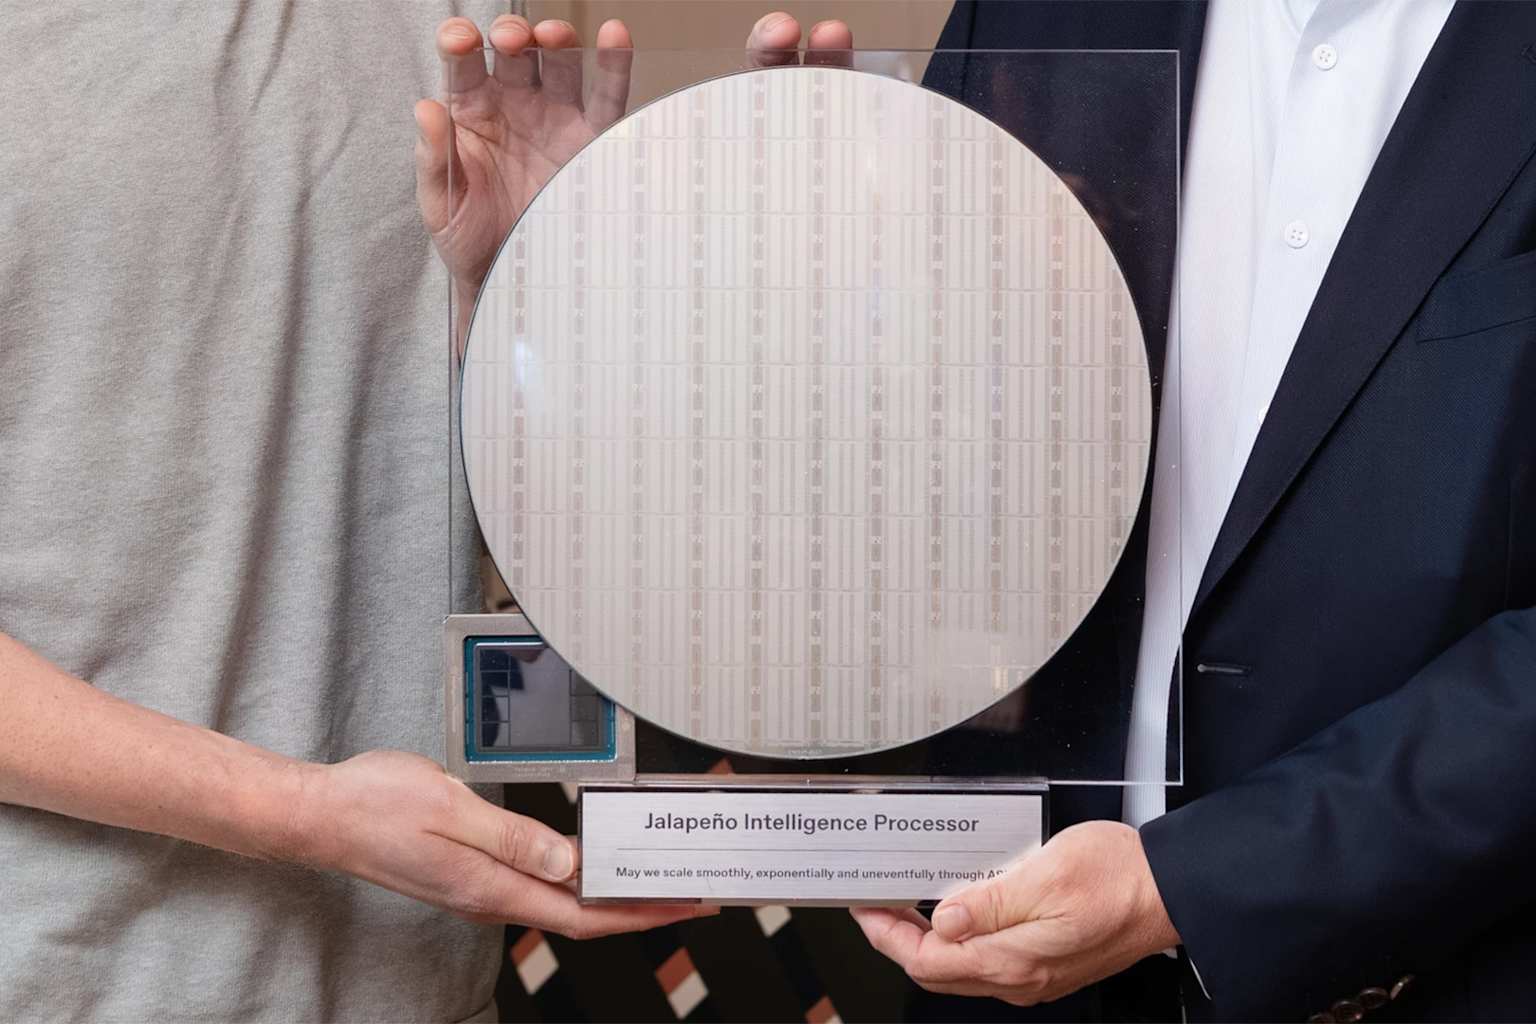
axios+1axios+1axiosOpenAI hat am Dienstag Benchmark-Ergebnisse vorgelegt, die zeigen, dass sein maßgeschneiderter Jalapeño-Inferenz-Chip Nvidia und andere Wettbewerber sowohl beim Durchsatz als auch bei der Energieeffizienz übertrifft. Dies ist der bisher detaillierteste öffentliche Vorstoß des KI-Unternehmens gegen die Hardware-Vormachtstellung des dominierenden Chipherstellers.
Die Benchmarks, die im Vorfeld von OpenAIs Präsentation auf der Halbleiterkonferenz „Hot Chips“ in Stanford veröffentlicht wurden, zeigen, dass Jalapeño die 1,5- bis 1,9-fache KI-Arbeitsleistung pro Watt erbringt und eine 1,7- bis 3,6-mal niedrigere End-to-End-Latenz aufweist als die GB200- und GB300-Systeme von Nvidia. Getestet wurde dies mit Modellen wie DeepSeek R1, der Version von Kimi K2.5 mit einer Billion Parametern sowie OpenAIs eigenem GPT-OSS 120B.axios+1
Der Chip, der gemeinsam mit Broadcom entwickelt und erstmals im Juni angedeutet wurde, wurde von Grund auf ausschließlich für die LLM-Inferenz konzipiert. Auf Systemebene enthält jedes Jalapeño-Rack 128 Beschleuniger, die eine Rechenleistung von 1,7 ExaFLOPS bei 4-Bit-Präzision, 27,5 TB HBM4-Speicher und eine Speicherbandbreite von fast 2 Petabyte pro Sekunde bereitstellen.theregister
Richard Ho, Vice President of Hardware bei OpenAI, erklärte gegenüber Journalisten, der Chip biete das „Beste aus beiden Welten“ mit geringerer Latenz und höherem Durchsatz, da KI-Systeme normalerweise „einen Kompromiss zwischen beiden eingehen müssen“.theverge
Laut SemiAnalysis, das seine Benchmark-Suite „InferenceX“ in den Labors von OpenAI auf dem Chip laufen ließ, erreichte Jalapeño bei DeepSeek R1 über 700 Token pro Sekunde und Nutzer bei einer Concurrency von 1. Dies gelang ganz ohne spekulatives Decodieren oder Prefill-Decode-Disaggregation: Techniken, auf die Konkurrenten angewiesen sind, um ihre Zahlen zu schönen.newsletter.semianalysis
OpenAI benötigte von der ersten Teameinstellung bis zum Tape-out der Fertigung rund 16 Monate, wobei der Chip im November 2025 fertiggestellt wurde. Das Unternehmen gab an, dass der Einsatz von KI-Unterstützung beim Design zu einer Reduzierung der SIMD-Fläche um 8 Prozent und der Matrix-Engine-Fläche um 10 Prozent beigetragen habe.newsletter.semianalysis
Dennoch ist Jalapeño nur für die Inferenz und nicht für das Training gedacht. „Wir werden eine Menge Rechenleistung benötigen“, sagte Ho. „Und Jalapeño ist ein Teil davon. Cerberus ist ein Teil davon. Nvidia ist ein Teil davon. AMD Advanced Micro Devices, Inc. ist ein Teil davon.“axios
OpenAI plant eine begrenzte Bereitstellung bis Ende 2026, wobei die Massenproduktion im Laufe des Jahres 2027 hochgefahren werden soll. Das Unternehmen entwickelt bereits einen Chip der zweiten Generation, und auch die Pläne für eine dritte Generation nehmen bereits Gestalt an.theverge+1
SemiAnalysis wies auf wichtige Einschränkungen hin: Die Benchmarks nutzten eine relativ einfache Arbeitslast von 8k-Input und 1k-Output anstelle der anspruchsvolleren agentischen Arbeitslasten, die Caching und Routing stark beanspruchen. Zudem wäre ein Vergleich mit der neueren Vera-Rubin-Architektur von Nvidia, die denselben HBM4-Speicher nutzt, eher ein Vergleich von Äpfeln mit Äpfeln.newsletter.semianalysis
Der Chip stößt in ein dicht gedrängtes Feld vor. Google Alphabet Inc. verfügt über seine TPU-Reihe, Amazon Amazon.com, Inc. und Microsoft haben eigene Designs, und Anthropic bestätigte Anfang des Monats, an einem eigenen Chip zu arbeiten. OpenAI hat keine Pläne, Jalapeño extern zu verkaufen. „Wir haben selbst so viel Bedarf dafür, dass wir uns nicht vorstellen können, wann wir dazu in der Lage wären“, sagte Ho.axios